大家好,我是潦草学者,一名长期的知识管理实践者,也是一名独立开发者。
我在 Obsidian 里积累了接近 2 万篇笔记。里面有读书摘录、日记、项目记录、过去发表的文章,也有很多当时觉得重要、后来再也没打开过的想法。
我在 Obsidian 里面实践了很长一段时间的 zettelksaten 方法。
但是随着
笔记越来越多,工作也组件繁忙以后。
我慢慢放弃了维护笔记和笔记之间的联系。
双向链接固然有价值,但是依赖人来维护。
知道三年前,我发现 embedding 这项技术以后,一直很想要在 Obsidian 里面构建一个 自己使用的向量数据库。
但再次之前,一直很难有可以在本地运行起来的 embedding 模型。直到今年,我发 MTEB 上,有很多模型的参数量已经可以在本地运行起来,并且效果还非常不错。
所以我做了 Analogy。
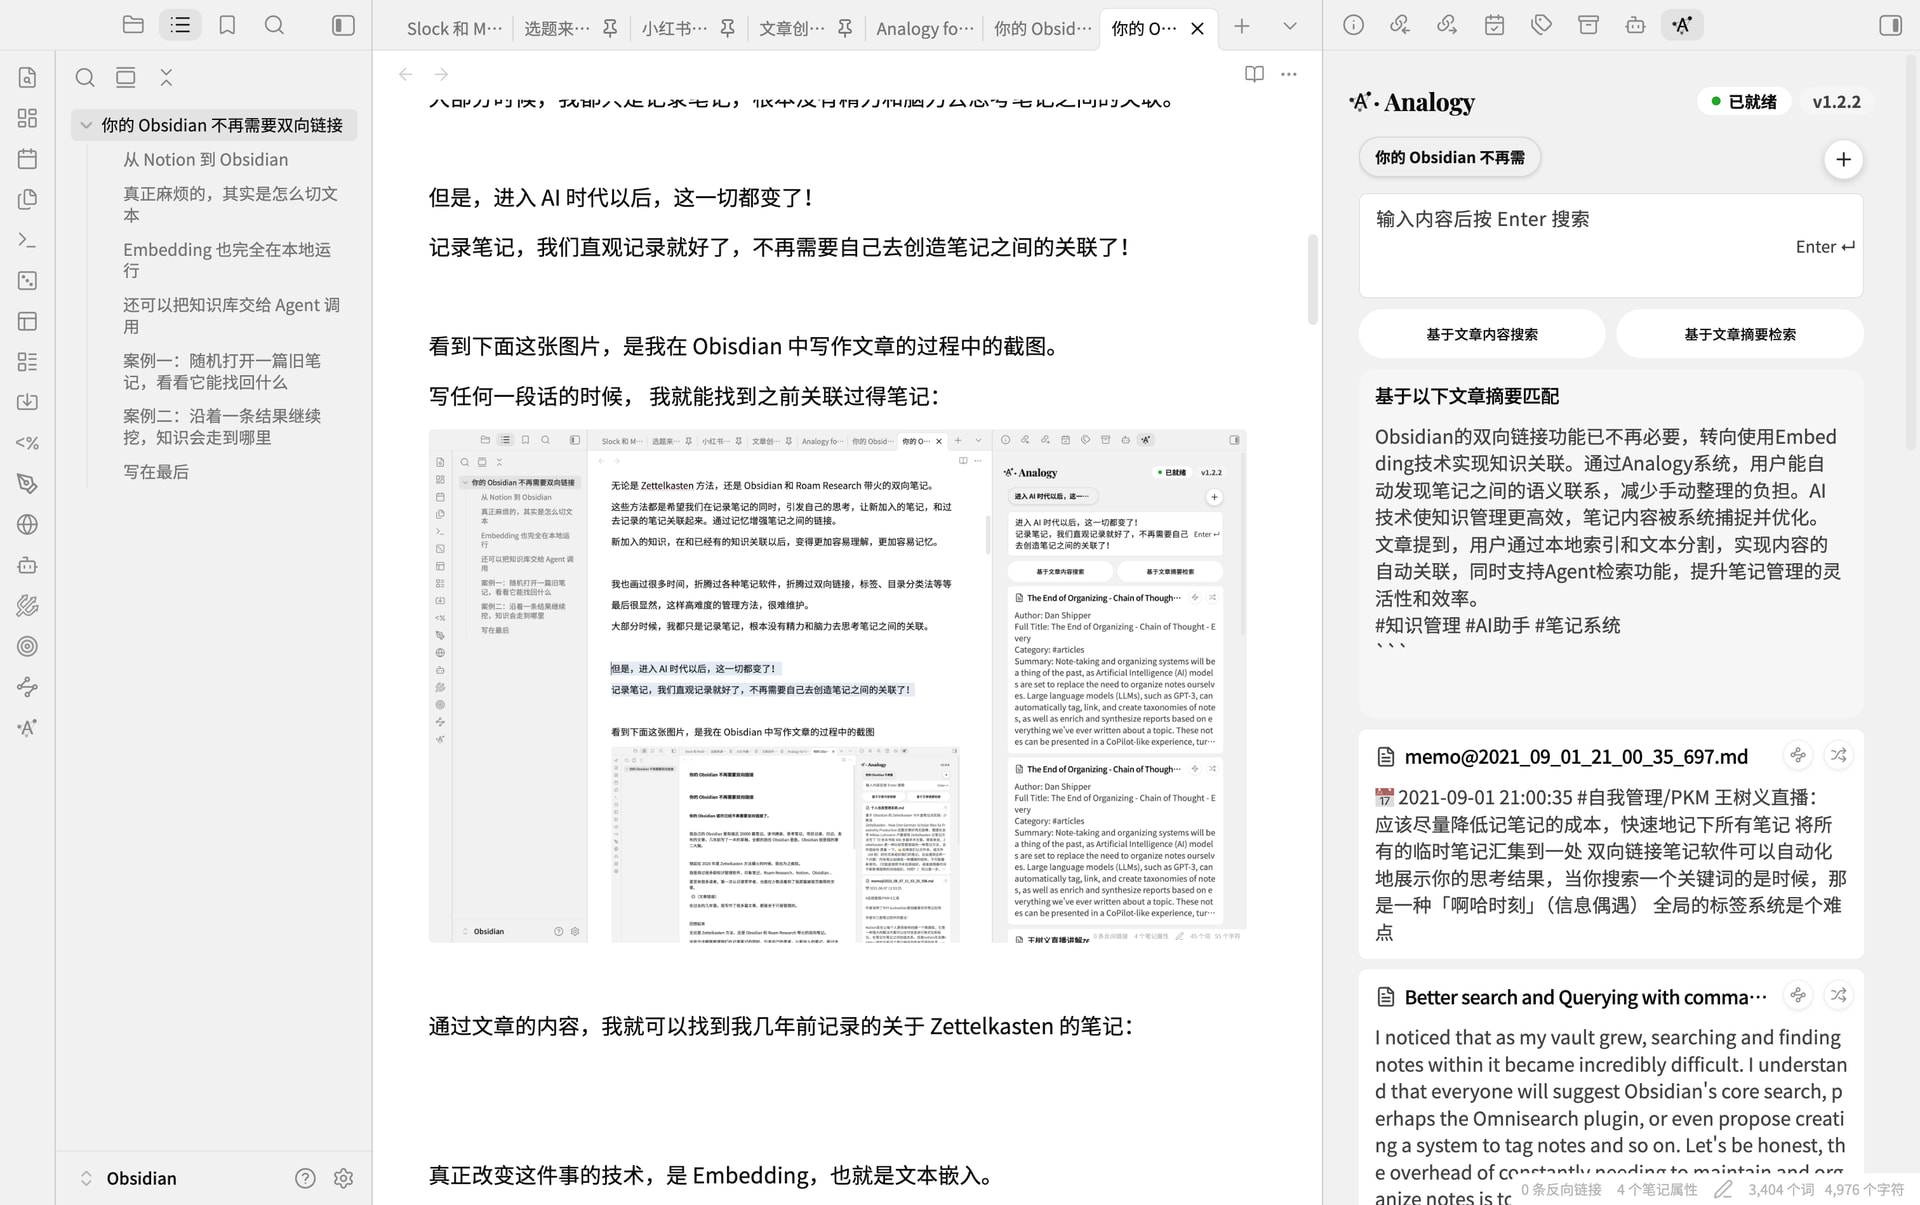
Analogy 是一个桌面端 Obsidian 插件。它在本地为 Markdown 笔记建立向量索引,让我可以用一句自然语言、一段正在写的文字,或者当前文档的内容,寻找语义上相关的旧笔记。
比如,我在写一篇关于“AI 时代的知识管理”的文章时,不需要先猜自己几年前用了什么关键词。我可以直接拿当前文章去搜索,找回以前写过的阅读笔记、项目复盘和零散观点。
这种体验和手动双链不太一样。手动链接保存的是我已经确认的关系;语义搜索给出的则是一组“可能相关”的内容。它偶尔也会找出一些意料之外的结果,但对写作和研究来说,这种偏差有时恰好能提供新的线索。
目前可以做什么
-
在侧边栏用自然语言搜索整个 vault。
-
从当前文档或选中的内容出发,寻找相关笔记片段。
-
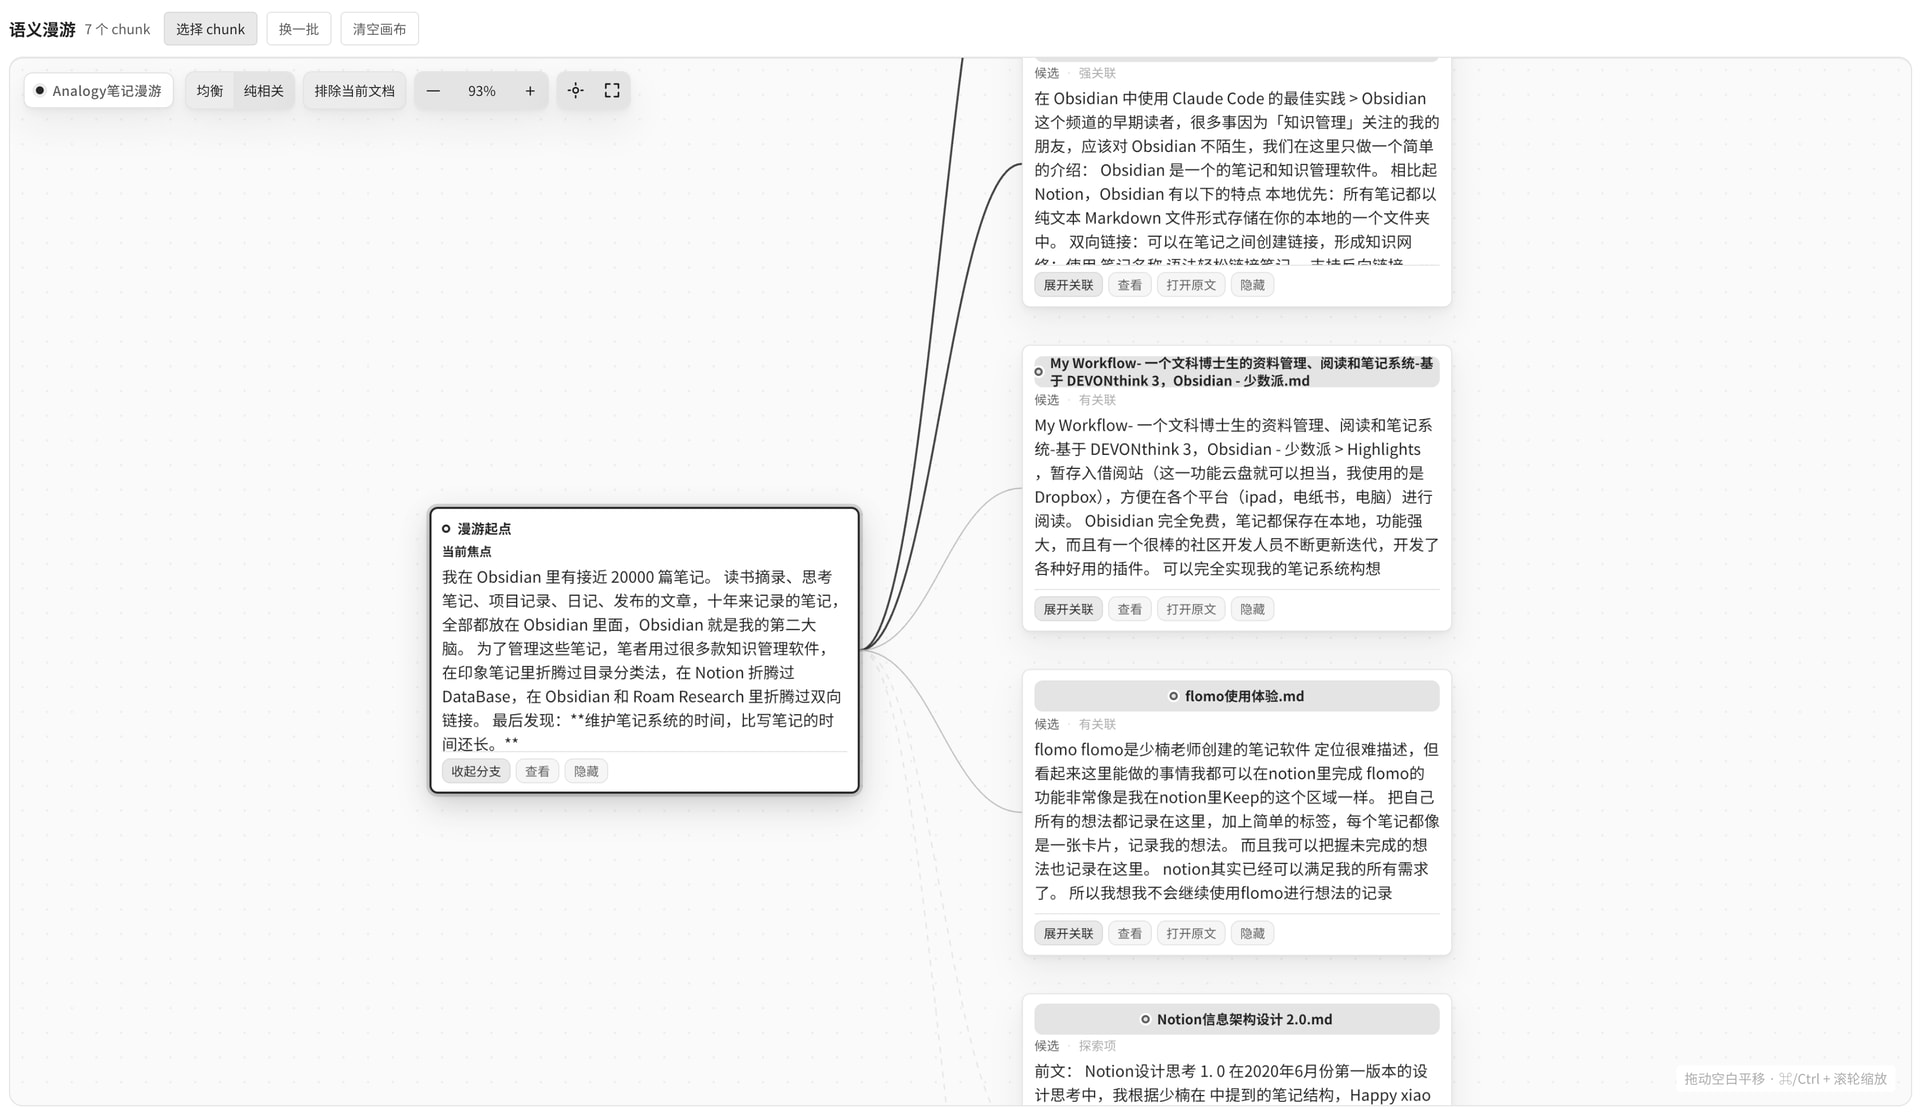
在 Semantic Walk 画布里沿着某个片段继续探索,查看笔记间没有被手动链接起来的关系。
-
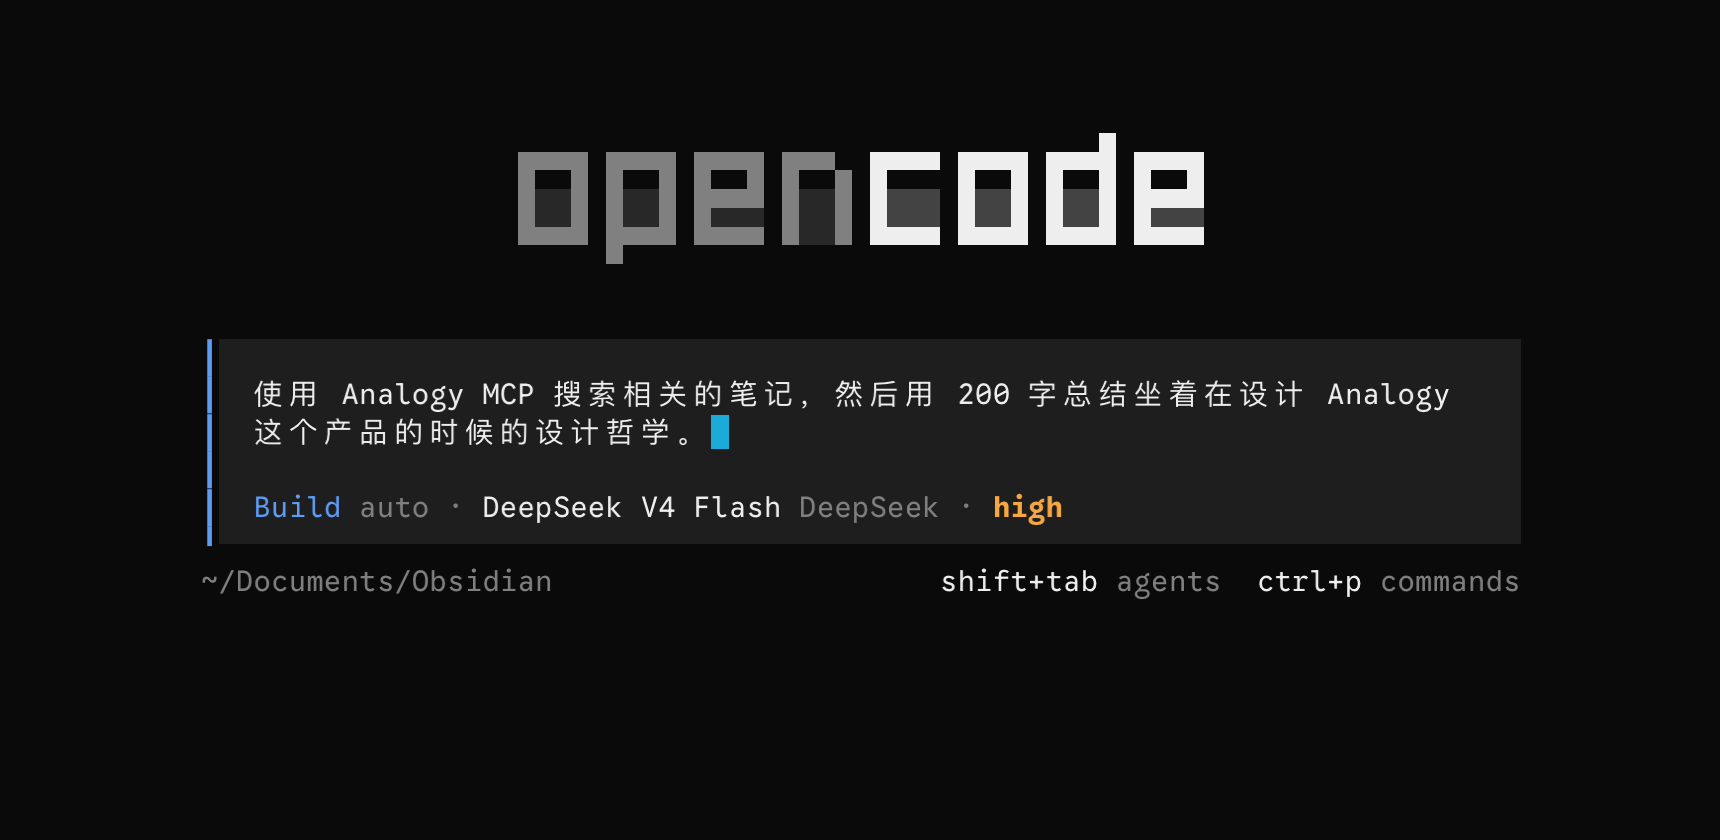
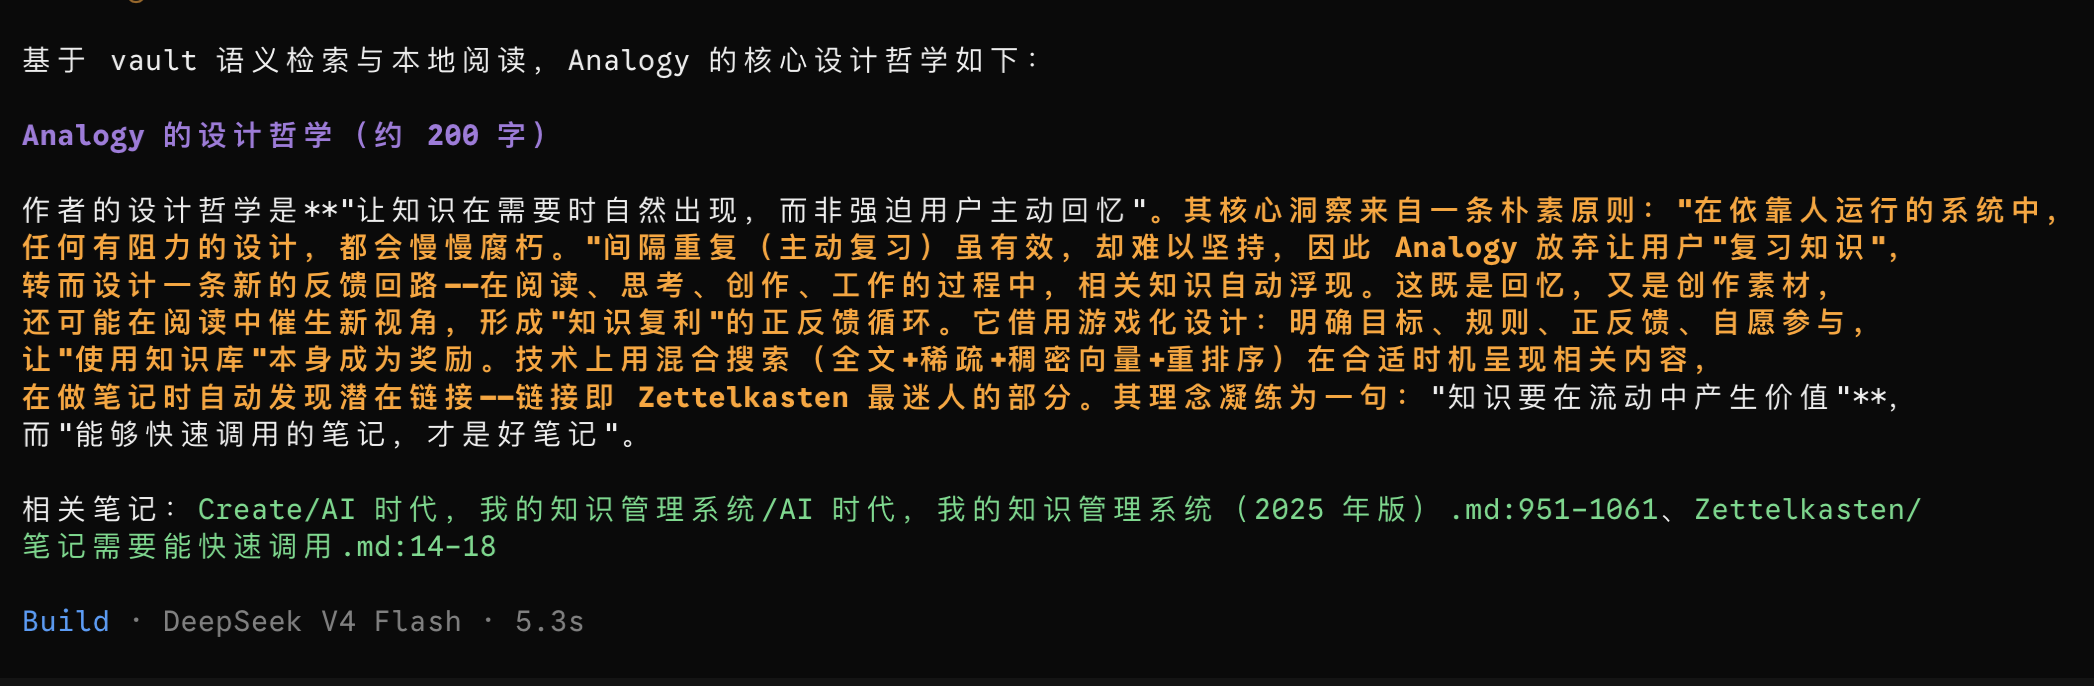
通过配套的 MCP Server,让 Claude Code、Cursor 等支持 MCP 的工具检索经过授权的笔记内容。

我不想再做一个把聊天窗口塞进 Obsidian 的插件。Analogy 更像是一层检索基础设施:Obsidian 继续负责保存和编辑笔记,Analogy 负责在需要时把相关内容找回来。
关于本地运行和隐私
这是我开发 Analogy 时最在意的部分。
Markdown 内容、向量索引、embedding 计算和 ChromaDB 检索都在本机完成,ChromaDB 默认只监听 127.0.0.1。插件不会为了许可证校验上传笔记正文、路径、查询内容或向量。
如果你主动配置 MCP Server,本地 AI 工具可以获得搜索结果片段。你也可以用路径白名单限制 MCP 能访问的目录。这个能力默认不会替你开启。
为了说清数据边界,也补充两点:首次安装需要联网下载经过固定版本和校验的本地运行时及 embedding 模型;使用许可证时,校验服务会收到许可证密钥、插件版本、本地设备标识和 vault 标识,但不会收到笔记内容。
现在的限制
Analogy 目前只支持桌面端。托管运行时主要支持 Apple Silicon Mac 和 Windows x64,Intel Mac 的运行时暂未提供。
第一次使用需要下载本地模型并建立索引。vault 越大,首次索引需要的时间越长。语义搜索也不是 Obsidian 原生搜索的替代品:查文件名、标签或确定的原句时,关键词搜索仍然更直接。
当前版本可以免费安装,免费版最多索引 2500 个 Markdown 文件。更大的 vault 可以选择个人付费许可。我把这一点直接写出来,方便大家在安装前判断是否适合自己。
安装与链接
Obsidian 插件市场:
源代码与问题反馈:
安装后,在 设置 → 第三方插件 中启用 Analogy。首次打开设置页时,向导会检查本地环境、安装运行时并引导建立第一个索引。
我做这个插件,首先是因为我自己需要它。知识管理做了很多年以后,我现在更关心的不是如何把系统整理得更漂亮,而是过去写下的东西能不能在今天的问题里重新出现。
如果你也有一个积累多年的 vault,欢迎来尝试这个插件。
也可以聊聊你在知识库里尝试 AI 技术的实践