美人儿呀
(Wrwe)
1
格式化内容的意思是,可以给内容设置字段、做成表格。
我有挺多这样的内容,比如收藏了一个链接之类的以后,评论个几十字。
这种内容,是一条一页,用页面属性好呢?还是都放在一页或几页里,用行内属性好?
放页面里的话,那页面就太多了。随便几句话就一页。我现在都有1万多页了。
而且内容分布在不同的页面里,太零碎。
但页面的好处是可以用 Bases 管理,也符合 Obsidian 的整体调性。
放行内的话,优点是内容集中,一页里面可以放很多条。
我自己用 ai 写了一个插件,往页面里新建条目,还算方便。
可是在页面里要用 Dataviewjs,页面一多的话,难免有性能问题。
我现在有个Dataviewjs 表格,加载200多行,就有点卡了。
求大神指教。
1 个赞
NewJin
5
DataLoom,不建议用这个插件,项目已经归档了。
个人不会使用行内属性,非md标准格式 后续如果有 笔记迁移需求 将会很麻烦。
除此之外,非md标准格式的第三方插件也不会使用,万一哪天不维护了数据处理得累死 
Ryooo
(Roy)
6
怎么感觉这个问题归根结底应该是怎么处理零散信息……
反正就属性来说,我个人还是推荐页面属性,毕竟相对更标准、规范。
美人儿呀
(Wrwe)
7
对的,就是处理零散信息。
用页面的话,真的是太多太多了。
我目前已经1万多页了。
不知道处理10万页的话(绝大部分md中内容很少), Obsidian 性能如何。
Ryooo
(Roy)
8
很久以前做过压力测试(OB没有做性能优化前),4万多的笔记只会在反链列表那块有卡顿,别的都不会有影响。现在性能应该是比那会更强的。
虽然我自己也1.5万篇笔记了,但是像这类内容我更多是放在zotero里做。或许这种拆分化管理的思路也可以应对性能焦虑。
美人儿呀
(Wrwe)
9
啊?zotero可以用来记录零碎片断?这个。。。新用法呀。
Ryooo
(Roy)
10
因为本质上来说,你需要评论的“链接”也可以视为一种文献,而你的评论就是对这篇文献的笔记 
用zotero还可以顺带帮你把原文抓下来
ob7
(ho)
12
这实际就是ob一大插件盲区——《块处理》,全用页面是更利于结构化,但不符合使用习惯,其实有个很好的解决方案,就是让Tasks插件也可以作用于非代办块,因为tasks已经建立起完善的代办管理机制,如果也能应用于非代办块那就是目前最完美的解决方案了,可惜我给tasks的作者提了这个意见后,人家不想做
美人儿呀
(Wrwe)
13
嗯,的确啊。可是如果不是评论链接呢?
比如随手一记的几句话,但又需要进入一定的结构中。
简而言之,就是 Obsidian 不能像 Notion 那样在表格中呈现非页面的属性。
这个问题我也曾经痛苦了很久,归根到底,是因为ob的颗粒度只到笔记一级。
ob的理念,似乎是把笔记作为基本单位;标签和属性都是为笔记服务的,base也是以笔记为单位来组织的。换句话说,如果在一篇笔记下面记录2个或以上不同的知识元,管理起来是非常别扭的;但是这恰恰是人类记笔记(或日记)的常用习惯。比如,我们写日记,早餐吃了啥,上午去哪玩,晚饭跟谁吃,都是在一篇笔记里面的、并不会分开3篇。同理,科研论文也不会分开几段写、会议记录也不会把几个部门的发言分开来存放。
我认为,最符合人类写笔记的颗粒度,是heading这一级。然而,ob空有heading的数据缓存(输入 [## 就能获得所有heading的候选),却不愿意提供heading的筛选和管理功能、base对于heading也是不考虑。
这几年我使用ob的折腾经历,我先是把散落的零星笔记都复制粘贴到daily note进行归总(一天一笔记,方便查阅),然后又为了迁就ob的颗粒度理念,重新把daily note打散成多篇笔记(为了在yaml区打上不同的标签和属性)。
我也曾经尝试把所有heading都增加一个task,就是为了借用dataview的task语句对heading层级进行聚合筛选,毕竟dataview的task语句是ob上唯一一个可以对块进行管理的可能途径;但是这始终是曲线救国,每个知识元都重复写上2次,非常臃肿。
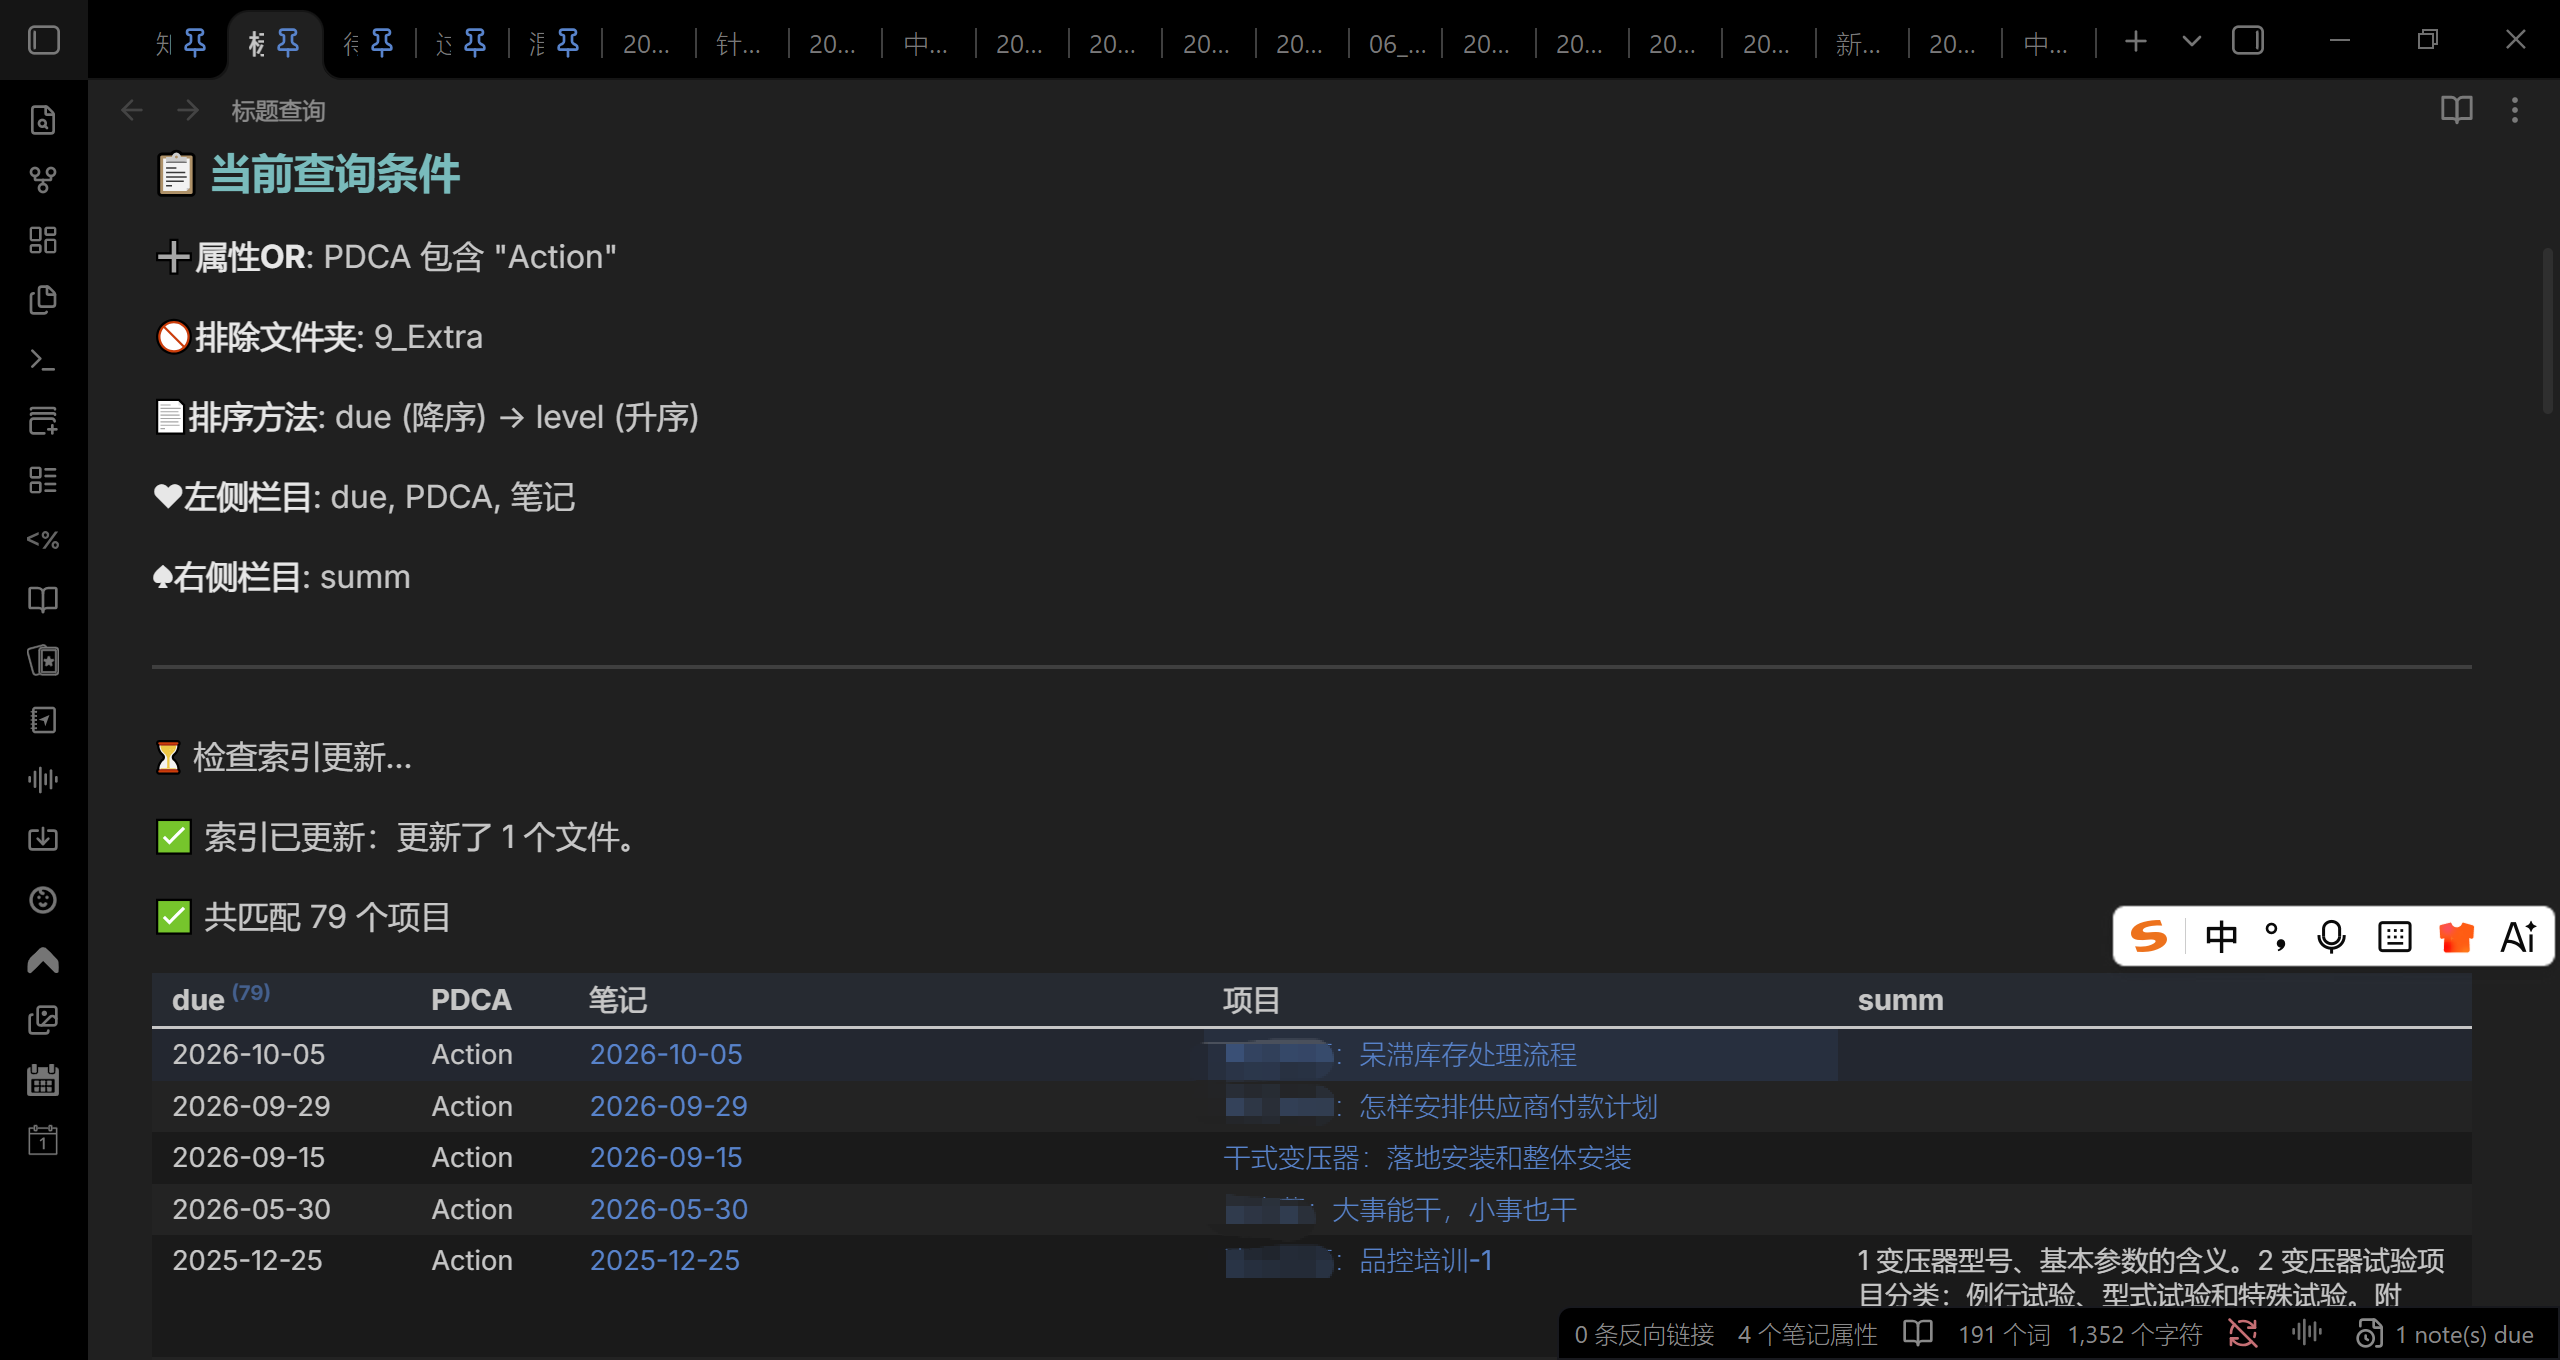
多亏了ai,在折腾忍受多年之后,我算是解决了这个问题,方法是手搓一个heading和task的json缓存(包含heading和task的行内标签、行内属性),然后用dataviewjs输出一个筛选聚合table。
- 方案包含一个索引脚本js、一个筛查输出脚本dataviewjs、一个缓存json
- json缓存,整合了ob官方和dataview的相关缓存(笔记、heading、tags、task等),所以不需要大规模逐行扫描全库。
- json缓存是增量更新的,只有在触发筛查输出脚本的时候,才会更新json缓存。我的笔记库有16000多笔记,增量更新和筛选感觉不到明显的卡顿,整个过程也就1-2秒的时间,跟dataview或base的体验差不多。
- task,我把task也视为heading纳入了索引范围。
- 行内标签、行内属性:任意两个heading或task之间存在行内标签或属性,都会被视为上一个heading或task的标签或属性;如果没有行内标签或行内属性,才用笔记yaml区的标签或属性递补。
这个手搓的半成品,跟ob和dataview的理念不同,自然两家都不会考虑去做;但是这样一个粗糙的、将就能用的小脚本,却让我用得非常方便,毕竟不用再拆分笔记了;而且也可以想到啥就直接开daily note新增一个heading,不需要考虑在哪里新建笔记来记。