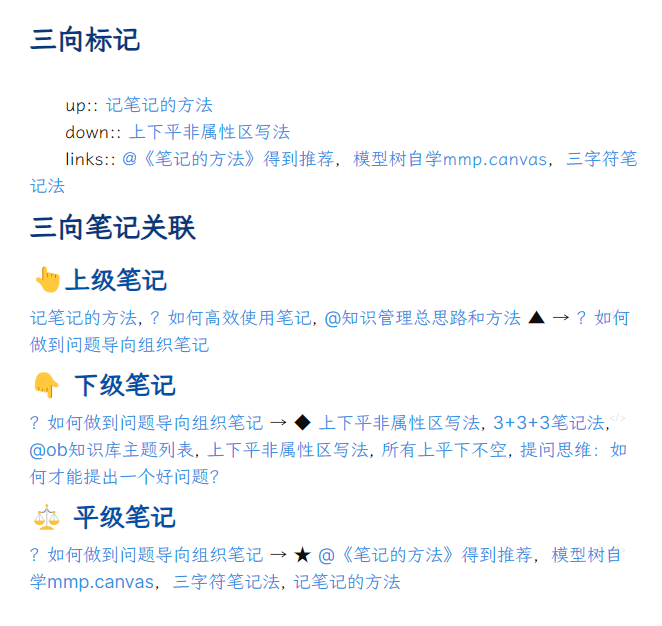
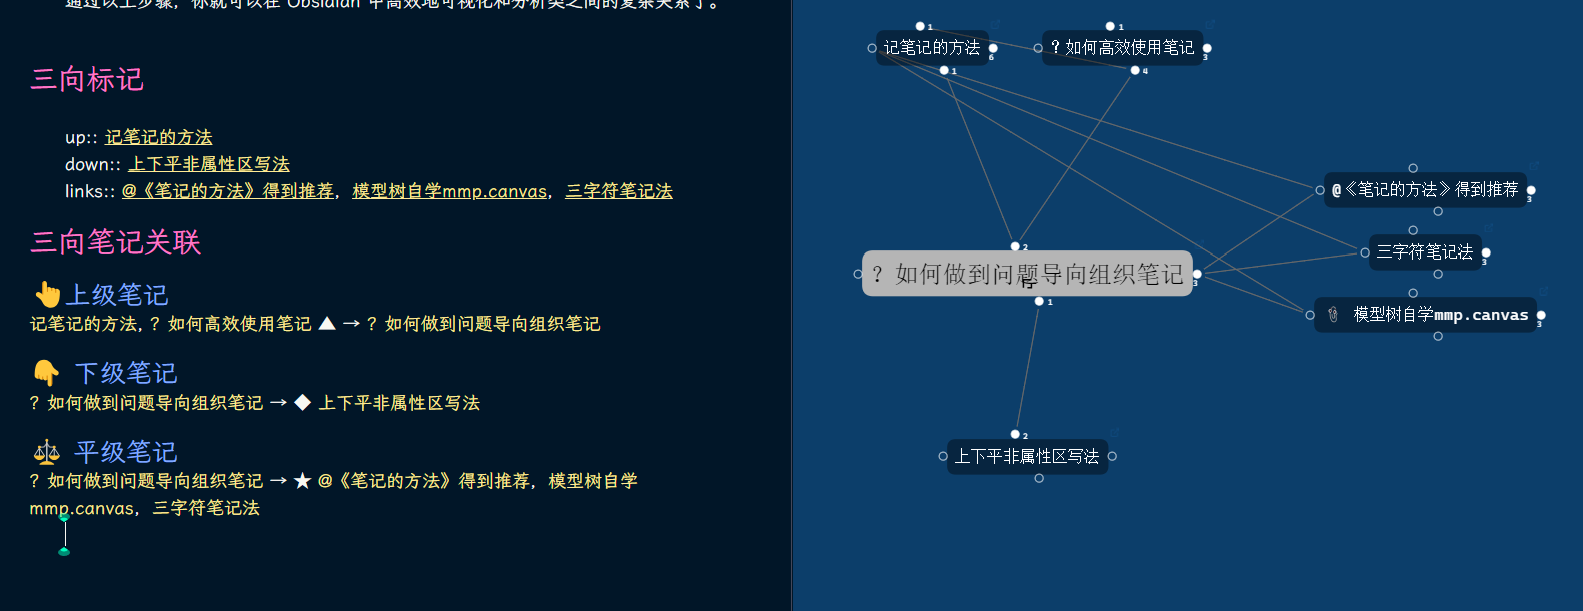
升级补充说明
- 把笔记别名、备注名、笔记标题级链接等,都可以按需显示(3.3版)
- 这一版的修改,是发现同名笔记汇集时有重复,然后发现没能显示别名,都修改了之后,就成现在这一版了。
三向标记
up::
down::
links::
三向笔记关联
 上级笔记
/* ===== 三向关联 3.3 · 上级笔记 =====
   汇总规则(双向互查,任一命中即显示):
     · 正向:本笔记自己的 KEY=`up` 字段;
     · 反向:谁的 OTHER=`down` 字段里写了本笔记,也汇总到这里
             (例:A 写 up 指向 B → B 的「下级笔记」里出现 A;平级同理互查)。
   取值三来源(互相独立,任一命中即采用,可叠加去重):
     A = dataview 解析值(frontmatter + 正文内联 `up::`)
     B = Obsidian 原生 metadataCache 的 frontmatter(绕开 dataview 解析)
     C = 直读正文文本解析内联字段(绕开 dataview 解析,带会话级缓存)
   显示规则:链接若显式带别名(如 `[[笔记名|别名]]`),汇总时显示别名;
            未带别名则显示主要笔记名(并以笔记名作为去重键)。
   兼容:ArrayValue 包装 / 空内联字段 / Link 对象 / 带引号 / 带路径 /
        带显示名 / 一行多链接 / 用别名指向 / 自动剔除自链。                 */

const DEBUG = false;        // 仍不显示时改成 true,会打印三来源原始取值
const KEY   = 'up';    // 本方向读取的字段
const OTHER = 'down';  // 反推汇集所依据的字段

/* ---------- 通用工具 ---------- */
const asList = (v) => {
  if (v == null) return [];
  if (Array.isArray(v)) return v;
  if (typeof v === 'object' && Array.isArray(v.value)) return v.value;  // dataview ArrayValue
  if (typeof v === 'object' && typeof v[Symbol.iterator] === 'function') return Array.from(v);
  return [v];
};
const textOf = (v) => {
  if (v == null) return '';
  if (typeof v === 'string') return v;
  if (typeof v === 'object') {
    if (typeof v.path === 'string') {                                   // dataview / metadataCache 的 Link 对象
      const disp = (typeof v.display === 'string' && v.display.trim()) ? v.display.trim() : '';
      // 重建完整 wikilink(保留显式别名);display 与 path 相同则退化为主名
      return (disp && disp !== v.path) ? `[[${v.path}|${disp}]]` : `[[${v.path}]]`;
    }
    if (typeof v.name === 'string')    return v.name;
    if (typeof v.value === 'string')   return v.value;
    if (typeof v.display === 'string') return v.display;
  }
  return String(v);
};
/* strip:[[目录/笔记.md|显示名]] / "[[笔记]]" / 纯文本 → 纯笔记名(用于去重/自链判定) */
const strip = (s) => {
  let x = String(s == null ? '' : s).trim().replace(/^["'「『【]+|["'」』】]+$/g, '');
  const m = x.match(/^\[\[(.+?)(?:\|.*?)?\]\]$/);
  return (m ? m[1] : x).split('/').pop().trim().replace(/\.md$/i, '');
};
const norm = (s) => strip(s).toLowerCase();
/* toLinkStr:单个 wikilink token → 用于渲染的链接串(保留显式别名) */
const toLinkStr = (t) => {
  const m = String(t).match(/^\[\[(.+?)(?:\|([^\]]*))?\]\]$/);
  if (!m) return null;
  const name  = m[1].split('/').pop().trim().replace(/\.md$/i, '');
  const alias = (m[2] != null) ? m[2].trim() : '';
  return name ? `[[${name}${alias ? '|' + alias : ''}]]` : null;
};
/* toLinks:任意来源 → ["[[笔记名|别名?]]", ...](用于渲染,别名随链接保留) */
const toLinks = (raw) => {
  const out = [];
  for (const v of asList(raw)) {
    if (v == null) continue;
    if (typeof v === 'object' && !Array.isArray(v)
        && Array.isArray(v.value) && typeof v.path !== 'string') {
      out.push(...toLinks(v.value)); continue;                    // 嵌套 ArrayValue
    }
    const s = textOf(v).trim();
    if (!s || s === '[object Object]') continue;
    const cells = s.match(/\[\[[^\]]+\]\]/g);
    for (const t of ((cells && cells.length) ? cells : [s])) {
      const lk = toLinkStr(t);
      if (lk) out.push(lk);
    }
  }
  return out;
};

/* 来源 B:Obsidian 原生 YAML frontmatter */
const fmOf = (page) => {
  try {
    const f = app.vault.getAbstractFileByPath(page && page.file ? page.file.path : '');
    const c = f ? app.metadataCache.getFileCache(f) : null;
    return (c && c.frontmatter) ? c.frontmatter : {};
  } catch (e) { return {}; }
};
/* 来源 A + B */
const fieldOf = (page, key) => {
  const out = [];
  try { out.push(...asList(page ? page[key] : null)); } catch (e) {}
  try { out.push(...asList(fmOf(page)[key])); } catch (e) {}
  return out;
};

/* 来源 C:直读正文解析内联字段(会话级缓存,5 分钟 / 文件数变化时重建) */
const inlineIndex = async () => {
  const g   = (typeof window !== 'undefined') ? window : globalThis;
  const KEYC = '__SX32_INLINE__';
  const files = app.vault.getMarkdownFiles();
  const c = g[KEYC];
  if (c && c.n === files.length && (Date.now() - c.t) < 300000) return c.map;
  const map = new Map();
  const BATCH = 300;
  for (let i = 0; i < files.length; i += BATCH) {
    const chunk = files.slice(i, i + BATCH);
    const texts = await Promise.all(chunk.map(f => app.vault.cachedRead(f).catch(() => '')));
    for (let k = 0; k < chunk.length; k++) {
      const txt = String(texts[k] || '').replace(/```[\s\S]*?```/g, '');   // 去掉代码块
      const rec = { up: [], down: [], links: [] };
      for (const m of txt.matchAll(/(?:^|[\s>\-*])(up|down|links)[ \t]*::[ \t]*([^\n]*)/gi)) {
        const v = (m[2] || '').trim();
        if (v) rec[m[1].toLowerCase()].push(v);
      }
      map.set(chunk[k].path, rec);
    }
  }
  g[KEYC] = { n: files.length, t: Date.now(), map };
  return map;
};

/* 本笔记可被识别为「我」的名字集合:文件名 + 全部别名 */
const cur   = dv.current();
const curLk = cur.file.link;
const curNm = cur.file.name;
const myNames = new Set();
for (const v of [curNm, cur.file.aliases, fmOf(cur).aliases, cur.aliases]) {
  for (const x of asList(v)) { const n = norm(x); if (n) myNames.add(n); }
}
/* 某个值里是否指向本笔记 */
const pointsToMe = (val) => {
  const s = String(val == null ? '' : val).trim();
  if (!s) return false;
  const cells = s.match(/\[\[[^\]]+\]\]/g);
  return ((cells && cells.length) ? cells : [s]).some(t => myNames.has(norm(t)));
};
/* 某页面的 key 字段(来源 A+B)是否指向本笔记 */
const hitsAB = (page, key) => {
  let loose = false;
  for (const v of fieldOf(page, key)) {
    const s = textOf(v);
    if (!s || s === '[object Object]') continue;
    if (pointsToMe(s)) return true;
    const cells = s.match(/\[\[[^\]]+\]\]/g);
    if (!cells && norm(s).indexOf(norm(curNm)) !== -1) loose = true;  // 无链接语法时退化为包含匹配
  }
  return loose;
};

/* ① 同步阶段:来源 A+B */
const selfSync = toLinks(fieldOf(cur, KEY));
const backSync = [], pending = [];
let scanned = 0;
for (const p of dv.pages().array()) {
  if (!p || !p.file) continue;
  scanned++;
  if (norm(p.file.name) === norm(curNm)) continue;               // 排除自己
  if (hitsAB(p, OTHER)) backSync.push(`[[${p.file.name}]]`);
  else pending.push(p);
}

const render = (list, note) => {
  // 以笔记名去重(避免同一笔记因别名不同而裂成多条),保留首个含别名的显示串
  const byName = new Map();
  for (const l of list) {
    const n = norm(l);
    if (n === norm(curNm)) continue;
    if (!byName.has(n)) byName.set(n, l);
  }
  const uniq = [...byName.values()].sort();
  if (uniq.length) { dv.paragraph(`${uniq.join(', ')} ▲→ ${curLk}`); return; }
  if (DEBUG) dv.paragraph([
    `⚠️ 无 ${KEY} 关联`, `curNm=${curNm}`,
    `myNames=${JSON.stringify([...myNames])}`,
    `A(dataview)=${JSON.stringify(fieldOf(cur, KEY).map(textOf))}`,
    `B(frontmatter)=${JSON.stringify(fmOf(cur)[KEY] || null)}`,
    `正向=${JSON.stringify(selfSync)}`, `反向=${JSON.stringify(backSync)}`,
    `已扫描=${scanned}`, `待内联复核=${pending.length}`, note || '',
  ].join(' | '));
};

/* ② 异步阶段:补上来源 C(正文内联字段)后一次性渲染 */
let done = false;
(async () => {
  const selfAll = [...selfSync], backAll = [...backSync];
  let note = '';
  try {
    const idx = await inlineIndex();
    const mine = idx.get(cur.file.path);
    if (mine) for (const v of (mine[KEY] || [])) selfAll.push(...toLinks(v));   // 本笔记正文内联
    for (const p of pending) {
      const rec = idx.get(p.file.path);
      if (rec && (rec[OTHER] || []).some(pointsToMe)) backAll.push(`[[${p.file.name}]]`);
    }
  } catch (e) { note = '内联索引异常:' + e; }
  if (!done) { done = true; render([...selfAll, ...backAll], note); }
})().catch(() => { if (!done) { done = true; render([...selfSync, ...backSync]); } });
 下级笔记
/* ===== 三向关联 3.3 · 下级笔记 =====
   汇总规则(双向互查,任一命中即显示):
     · 正向:本笔记自己的 KEY=`down` 字段;
     · 反向:谁的 OTHER=`up` 字段里写了本笔记,也汇总到这里
             (例:A 写 up 指向 B → B 的「下级笔记」里出现 A;平级同理互查)。
   取值三来源(互相独立,任一命中即采用,可叠加去重):
     A = dataview 解析值(frontmatter + 正文内联 `down::`)
     B = Obsidian 原生 metadataCache 的 frontmatter(绕开 dataview 解析)
     C = 直读正文文本解析内联字段(绕开 dataview 解析,带会话级缓存)
   显示规则:链接若显式带别名(如 `[[笔记名|别名]]`),汇总时显示别名;
            未带别名则显示主要笔记名(并以笔记名作为去重键)。
   兼容:ArrayValue 包装 / 空内联字段 / Link 对象 / 带引号 / 带路径 /
        带显示名 / 一行多链接 / 用别名指向 / 自动剔除自链。                 */

const DEBUG = false;        // 仍不显示时改成 true,会打印三来源原始取值
const KEY   = 'down';    // 本方向读取的字段
const OTHER = 'up';  // 反推汇集所依据的字段

/* ---------- 通用工具 ---------- */
const asList = (v) => {
  if (v == null) return [];
  if (Array.isArray(v)) return v;
  if (typeof v === 'object' && Array.isArray(v.value)) return v.value;  // dataview ArrayValue
  if (typeof v === 'object' && typeof v[Symbol.iterator] === 'function') return Array.from(v);
  return [v];
};
const textOf = (v) => {
  if (v == null) return '';
  if (typeof v === 'string') return v;
  if (typeof v === 'object') {
    if (typeof v.path === 'string') {                                   // dataview / metadataCache 的 Link 对象
      const disp = (typeof v.display === 'string' && v.display.trim()) ? v.display.trim() : '';
      // 重建完整 wikilink(保留显式别名);display 与 path 相同则退化为主名
      return (disp && disp !== v.path) ? `[[${v.path}|${disp}]]` : `[[${v.path}]]`;
    }
    if (typeof v.name === 'string')    return v.name;
    if (typeof v.value === 'string')   return v.value;
    if (typeof v.display === 'string') return v.display;
  }
  return String(v);
};
/* strip:[[目录/笔记.md|显示名]] / "[[笔记]]" / 纯文本 → 纯笔记名(用于去重/自链判定) */
const strip = (s) => {
  let x = String(s == null ? '' : s).trim().replace(/^["'「『【]+|["'」』】]+$/g, '');
  const m = x.match(/^\[\[(.+?)(?:\|.*?)?\]\]$/);
  return (m ? m[1] : x).split('/').pop().trim().replace(/\.md$/i, '');
};
const norm = (s) => strip(s).toLowerCase();
/* toLinkStr:单个 wikilink token → 用于渲染的链接串(保留显式别名) */
const toLinkStr = (t) => {
  const m = String(t).match(/^\[\[(.+?)(?:\|([^\]]*))?\]\]$/);
  if (!m) return null;
  const name  = m[1].split('/').pop().trim().replace(/\.md$/i, '');
  const alias = (m[2] != null) ? m[2].trim() : '';
  return name ? `[[${name}${alias ? '|' + alias : ''}]]` : null;
};
/* toLinks:任意来源 → ["[[笔记名|别名?]]", ...](用于渲染,别名随链接保留) */
const toLinks = (raw) => {
  const out = [];
  for (const v of asList(raw)) {
    if (v == null) continue;
    if (typeof v === 'object' && !Array.isArray(v)
        && Array.isArray(v.value) && typeof v.path !== 'string') {
      out.push(...toLinks(v.value)); continue;                    // 嵌套 ArrayValue
    }
    const s = textOf(v).trim();
    if (!s || s === '[object Object]') continue;
    const cells = s.match(/\[\[[^\]]+\]\]/g);
    for (const t of ((cells && cells.length) ? cells : [s])) {
      const lk = toLinkStr(t);
      if (lk) out.push(lk);
    }
  }
  return out;
};

/* 来源 B:Obsidian 原生 YAML frontmatter */
const fmOf = (page) => {
  try {
    const f = app.vault.getAbstractFileByPath(page && page.file ? page.file.path : '');
    const c = f ? app.metadataCache.getFileCache(f) : null;
    return (c && c.frontmatter) ? c.frontmatter : {};
  } catch (e) { return {}; }
};
/* 来源 A + B */
const fieldOf = (page, key) => {
  const out = [];
  try { out.push(...asList(page ? page[key] : null)); } catch (e) {}
  try { out.push(...asList(fmOf(page)[key])); } catch (e) {}
  return out;
};

/* 来源 C:直读正文解析内联字段(会话级缓存,5 分钟 / 文件数变化时重建) */
const inlineIndex = async () => {
  const g   = (typeof window !== 'undefined') ? window : globalThis;
  const KEYC = '__SX32_INLINE__';
  const files = app.vault.getMarkdownFiles();
  const c = g[KEYC];
  if (c && c.n === files.length && (Date.now() - c.t) < 300000) return c.map;
  const map = new Map();
  const BATCH = 300;
  for (let i = 0; i < files.length; i += BATCH) {
    const chunk = files.slice(i, i + BATCH);
    const texts = await Promise.all(chunk.map(f => app.vault.cachedRead(f).catch(() => '')));
    for (let k = 0; k < chunk.length; k++) {
      const txt = String(texts[k] || '').replace(/```[\s\S]*?```/g, '');   // 去掉代码块
      const rec = { up: [], down: [], links: [] };
      for (const m of txt.matchAll(/(?:^|[\s>\-*])(up|down|links)[ \t]*::[ \t]*([^\n]*)/gi)) {
        const v = (m[2] || '').trim();
        if (v) rec[m[1].toLowerCase()].push(v);
      }
      map.set(chunk[k].path, rec);
    }
  }
  g[KEYC] = { n: files.length, t: Date.now(), map };
  return map;
};

/* 本笔记可被识别为「我」的名字集合:文件名 + 全部别名 */
const cur   = dv.current();
const curLk = cur.file.link;
const curNm = cur.file.name;
const myNames = new Set();
for (const v of [curNm, cur.file.aliases, fmOf(cur).aliases, cur.aliases]) {
  for (const x of asList(v)) { const n = norm(x); if (n) myNames.add(n); }
}
/* 某个值里是否指向本笔记 */
const pointsToMe = (val) => {
  const s = String(val == null ? '' : val).trim();
  if (!s) return false;
  const cells = s.match(/\[\[[^\]]+\]\]/g);
  return ((cells && cells.length) ? cells : [s]).some(t => myNames.has(norm(t)));
};
/* 某页面的 key 字段(来源 A+B)是否指向本笔记 */
const hitsAB = (page, key) => {
  let loose = false;
  for (const v of fieldOf(page, key)) {
    const s = textOf(v);
    if (!s || s === '[object Object]') continue;
    if (pointsToMe(s)) return true;
    const cells = s.match(/\[\[[^\]]+\]\]/g);
    if (!cells && norm(s).indexOf(norm(curNm)) !== -1) loose = true;  // 无链接语法时退化为包含匹配
  }
  return loose;
};

/* ① 同步阶段:来源 A+B */
const selfSync = toLinks(fieldOf(cur, KEY));
const backSync = [], pending = [];
let scanned = 0;
for (const p of dv.pages().array()) {
  if (!p || !p.file) continue;
  scanned++;
  if (norm(p.file.name) === norm(curNm)) continue;               // 排除自己
  if (hitsAB(p, OTHER)) backSync.push(`[[${p.file.name}]]`);
  else pending.push(p);
}

const render = (list, note) => {
  // 以笔记名去重(避免同一笔记因别名不同而裂成多条),保留首个含别名的显示串
  const byName = new Map();
  for (const l of list) {
    const n = norm(l);
    if (n === norm(curNm)) continue;
    if (!byName.has(n)) byName.set(n, l);
  }
  const uniq = [...byName.values()].sort();
  if (uniq.length) { dv.paragraph(`${curLk} →▼ ${uniq.join(', ')}`); return; }
  if (DEBUG) dv.paragraph([
    `⚠️ 无 ${KEY} 关联`, `curNm=${curNm}`,
    `myNames=${JSON.stringify([...myNames])}`,
    `A(dataview)=${JSON.stringify(fieldOf(cur, KEY).map(textOf))}`,
    `B(frontmatter)=${JSON.stringify(fmOf(cur)[KEY] || null)}`,
    `正向=${JSON.stringify(selfSync)}`, `反向=${JSON.stringify(backSync)}`,
    `已扫描=${scanned}`, `待内联复核=${pending.length}`, note || '',
  ].join(' | '));
};

/* ② 异步阶段:补上来源 C(正文内联字段)后一次性渲染 */
let done = false;
(async () => {
  const selfAll = [...selfSync], backAll = [...backSync];
  let note = '';
  try {
    const idx = await inlineIndex();
    const mine = idx.get(cur.file.path);
    if (mine) for (const v of (mine[KEY] || [])) selfAll.push(...toLinks(v));   // 本笔记正文内联
    for (const p of pending) {
      const rec = idx.get(p.file.path);
      if (rec && (rec[OTHER] || []).some(pointsToMe)) backAll.push(`[[${p.file.name}]]`);
    }
  } catch (e) { note = '内联索引异常:' + e; }
  if (!done) { done = true; render([...selfAll, ...backAll], note); }
})().catch(() => { if (!done) { done = true; render([...selfSync, ...backSync]); } });
 平级笔记
/* ===== 三向关联 3.3 · 平级笔记 =====
   汇总规则(双向互查,任一命中即显示):
     · 正向:本笔记自己的 KEY=`links` 字段;
     · 反向:谁的 OTHER=`links` 字段里写了本笔记,也汇总到这里
             (例:A 写 up 指向 B → B 的「下级笔记」里出现 A;平级同理互查)。
   取值三来源(互相独立,任一命中即采用,可叠加去重):
     A = dataview 解析值(frontmatter + 正文内联 `links::`)
     B = Obsidian 原生 metadataCache 的 frontmatter(绕开 dataview 解析)
     C = 直读正文文本解析内联字段(绕开 dataview 解析,带会话级缓存)
   显示规则:链接若显式带别名(如 `[[笔记名|别名]]`),汇总时显示别名;
            未带别名则显示主要笔记名(并以笔记名作为去重键)。
   兼容:ArrayValue 包装 / 空内联字段 / Link 对象 / 带引号 / 带路径 /
        带显示名 / 一行多链接 / 用别名指向 / 自动剔除自链。                 */

const DEBUG = false;        // 仍不显示时改成 true,会打印三来源原始取值
const KEY   = 'links';    // 本方向读取的字段
const OTHER = 'links';  // 反推汇集所依据的字段

/* ---------- 通用工具 ---------- */
const asList = (v) => {
  if (v == null) return [];
  if (Array.isArray(v)) return v;
  if (typeof v === 'object' && Array.isArray(v.value)) return v.value;  // dataview ArrayValue
  if (typeof v === 'object' && typeof v[Symbol.iterator] === 'function') return Array.from(v);
  return [v];
};
const textOf = (v) => {
  if (v == null) return '';
  if (typeof v === 'string') return v;
  if (typeof v === 'object') {
    if (typeof v.path === 'string') {                                   // dataview / metadataCache 的 Link 对象
      const disp = (typeof v.display === 'string' && v.display.trim()) ? v.display.trim() : '';
      // 重建完整 wikilink(保留显式别名);display 与 path 相同则退化为主名
      return (disp && disp !== v.path) ? `[[${v.path}|${disp}]]` : `[[${v.path}]]`;
    }
    if (typeof v.name === 'string')    return v.name;
    if (typeof v.value === 'string')   return v.value;
    if (typeof v.display === 'string') return v.display;
  }
  return String(v);
};
/* strip:[[目录/笔记.md|显示名]] / "[[笔记]]" / 纯文本 → 纯笔记名(用于去重/自链判定) */
const strip = (s) => {
  let x = String(s == null ? '' : s).trim().replace(/^["'「『【]+|["'」』】]+$/g, '');
  const m = x.match(/^\[\[(.+?)(?:\|.*?)?\]\]$/);
  return (m ? m[1] : x).split('/').pop().trim().replace(/\.md$/i, '');
};
const norm = (s) => strip(s).toLowerCase();
/* toLinkStr:单个 wikilink token → 用于渲染的链接串(保留显式别名) */
const toLinkStr = (t) => {
  const m = String(t).match(/^\[\[(.+?)(?:\|([^\]]*))?\]\]$/);
  if (!m) return null;
  const name  = m[1].split('/').pop().trim().replace(/\.md$/i, '');
  const alias = (m[2] != null) ? m[2].trim() : '';
  return name ? `[[${name}${alias ? '|' + alias : ''}]]` : null;
};
/* toLinks:任意来源 → ["[[笔记名|别名?]]", ...](用于渲染,别名随链接保留) */
const toLinks = (raw) => {
  const out = [];
  for (const v of asList(raw)) {
    if (v == null) continue;
    if (typeof v === 'object' && !Array.isArray(v)
        && Array.isArray(v.value) && typeof v.path !== 'string') {
      out.push(...toLinks(v.value)); continue;                    // 嵌套 ArrayValue
    }
    const s = textOf(v).trim();
    if (!s || s === '[object Object]') continue;
    const cells = s.match(/\[\[[^\]]+\]\]/g);
    for (const t of ((cells && cells.length) ? cells : [s])) {
      const lk = toLinkStr(t);
      if (lk) out.push(lk);
    }
  }
  return out;
};

/* 来源 B:Obsidian 原生 YAML frontmatter */
const fmOf = (page) => {
  try {
    const f = app.vault.getAbstractFileByPath(page && page.file ? page.file.path : '');
    const c = f ? app.metadataCache.getFileCache(f) : null;
    return (c && c.frontmatter) ? c.frontmatter : {};
  } catch (e) { return {}; }
};
/* 来源 A + B */
const fieldOf = (page, key) => {
  const out = [];
  try { out.push(...asList(page ? page[key] : null)); } catch (e) {}
  try { out.push(...asList(fmOf(page)[key])); } catch (e) {}
  return out;
};

/* 来源 C:直读正文解析内联字段(会话级缓存,5 分钟 / 文件数变化时重建) */
const inlineIndex = async () => {
  const g   = (typeof window !== 'undefined') ? window : globalThis;
  const KEYC = '__SX32_INLINE__';
  const files = app.vault.getMarkdownFiles();
  const c = g[KEYC];
  if (c && c.n === files.length && (Date.now() - c.t) < 300000) return c.map;
  const map = new Map();
  const BATCH = 300;
  for (let i = 0; i < files.length; i += BATCH) {
    const chunk = files.slice(i, i + BATCH);
    const texts = await Promise.all(chunk.map(f => app.vault.cachedRead(f).catch(() => '')));
    for (let k = 0; k < chunk.length; k++) {
      const txt = String(texts[k] || '').replace(/```[\s\S]*?```/g, '');   // 去掉代码块
      const rec = { up: [], down: [], links: [] };
      for (const m of txt.matchAll(/(?:^|[\s>\-*])(up|down|links)[ \t]*::[ \t]*([^\n]*)/gi)) {
        const v = (m[2] || '').trim();
        if (v) rec[m[1].toLowerCase()].push(v);
      }
      map.set(chunk[k].path, rec);
    }
  }
  g[KEYC] = { n: files.length, t: Date.now(), map };
  return map;
};

/* 本笔记可被识别为「我」的名字集合:文件名 + 全部别名 */
const cur   = dv.current();
const curLk = cur.file.link;
const curNm = cur.file.name;
const myNames = new Set();
for (const v of [curNm, cur.file.aliases, fmOf(cur).aliases, cur.aliases]) {
  for (const x of asList(v)) { const n = norm(x); if (n) myNames.add(n); }
}
/* 某个值里是否指向本笔记 */
const pointsToMe = (val) => {
  const s = String(val == null ? '' : val).trim();
  if (!s) return false;
  const cells = s.match(/\[\[[^\]]+\]\]/g);
  return ((cells && cells.length) ? cells : [s]).some(t => myNames.has(norm(t)));
};
/* 某页面的 key 字段(来源 A+B)是否指向本笔记 */
const hitsAB = (page, key) => {
  let loose = false;
  for (const v of fieldOf(page, key)) {
    const s = textOf(v);
    if (!s || s === '[object Object]') continue;
    if (pointsToMe(s)) return true;
    const cells = s.match(/\[\[[^\]]+\]\]/g);
    if (!cells && norm(s).indexOf(norm(curNm)) !== -1) loose = true;  // 无链接语法时退化为包含匹配
  }
  return loose;
};

/* ① 同步阶段:来源 A+B */
const selfSync = toLinks(fieldOf(cur, KEY));
const backSync = [], pending = [];
let scanned = 0;
for (const p of dv.pages().array()) {
  if (!p || !p.file) continue;
  scanned++;
  if (norm(p.file.name) === norm(curNm)) continue;               // 排除自己
  if (hitsAB(p, OTHER)) backSync.push(`[[${p.file.name}]]`);
  else pending.push(p);
}

const render = (list, note) => {
  // 以笔记名去重(避免同一笔记因别名不同而裂成多条),保留首个含别名的显示串
  const byName = new Map();
  for (const l of list) {
    const n = norm(l);
    if (n === norm(curNm)) continue;
    if (!byName.has(n)) byName.set(n, l);
  }
  const uniq = [...byName.values()].sort();
  if (uniq.length) { dv.paragraph(`${curLk} ↔ ${uniq.join(', ')}`); return; }
  if (DEBUG) dv.paragraph([
    `⚠️ 无 ${KEY} 关联`, `curNm=${curNm}`,
    `myNames=${JSON.stringify([...myNames])}`,
    `A(dataview)=${JSON.stringify(fieldOf(cur, KEY).map(textOf))}`,
    `B(frontmatter)=${JSON.stringify(fmOf(cur)[KEY] || null)}`,
    `正向=${JSON.stringify(selfSync)}`, `反向=${JSON.stringify(backSync)}`,
    `已扫描=${scanned}`, `待内联复核=${pending.length}`, note || '',
  ].join(' | '));
};

/* ② 异步阶段:补上来源 C(正文内联字段)后一次性渲染 */
let done = false;
(async () => {
  const selfAll = [...selfSync], backAll = [...backSync];
  let note = '';
  try {
    const idx = await inlineIndex();
    const mine = idx.get(cur.file.path);
    if (mine) for (const v of (mine[KEY] || [])) selfAll.push(...toLinks(v));   // 本笔记正文内联
    for (const p of pending) {
      const rec = idx.get(p.file.path);
      if (rec && (rec[OTHER] || []).some(pointsToMe)) backAll.push(`[[${p.file.name}]]`);
    }
  } catch (e) { note = '内联索引异常:' + e; }
  if (!done) { done = true; render([...selfAll, ...backAll], note); }
})().catch(() => { if (!done) { done = true; render([...selfSync, ...backSync]); } });
以上模板是dataviewjs代码,由两部分合并组成,一个部分显示本笔记中的标记关系,另一部分汇集其他笔记中标记的与本笔记的关系(反推汇集),最后合并在本笔记对应上、下、平关系中显示。