大家好,在这里介绍一下我最近做的一个插件吧,不知道大家会不会遇到这样的情况,看自己笔记的时候,碰到了自己想要了解的概念,或者想看看别人(如ai)对某个你笔记里的概念的看法,然后呢你就去找gpt或者豆包去了,但是吧,gpt它也不知道你笔记记了啥,你还要给他喂上下文,除此之外呢你有可能会在对话里对不同概念做个多次询问,这样问多了,结束后,可能随手就扔了,而且,如果你想存下来,又会遇见麻烦,这对话也太长了,而且涉及不同概念,整理起来实在麻烦。我说到这肯定有人说:skill!claudian!!
我只是问一个问题,搞清一个概念,用这些agent花我100万token(虽然90多缓存命中),你是要我的命吗。
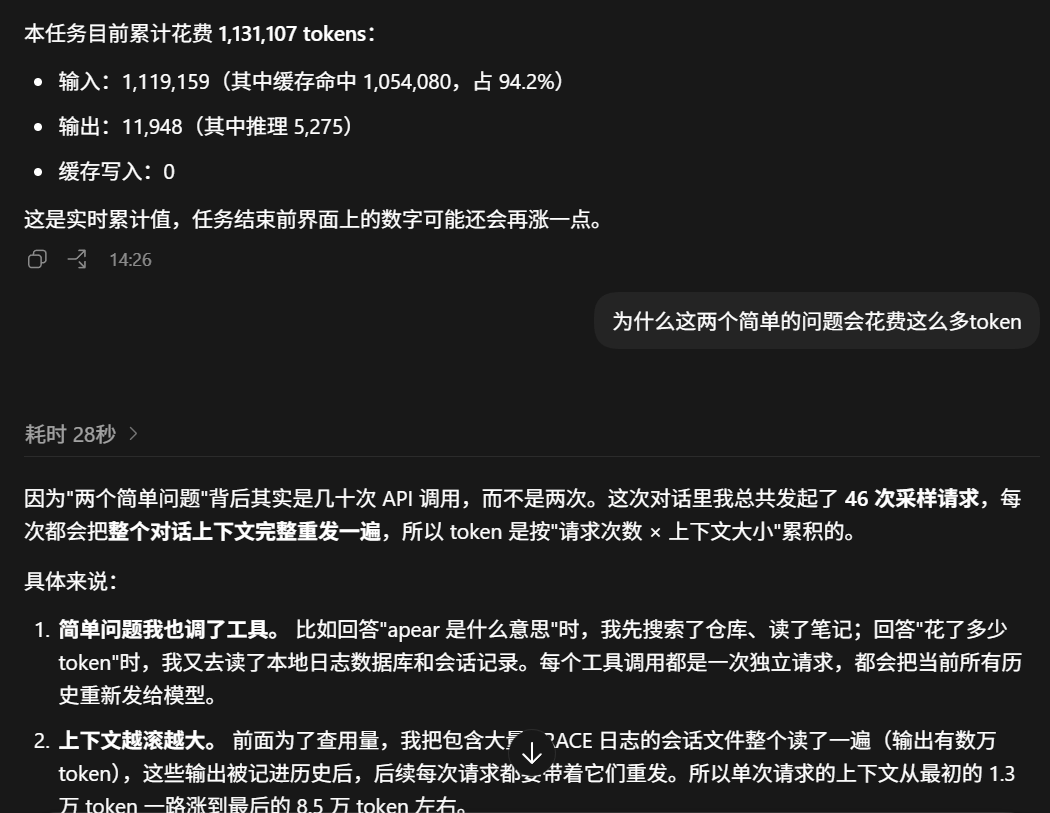
我受不了了
然后我自己做了个插件。
它的逻辑非常简单:deepseek的api接口+agent操控的按需调用的渐进式上下文+不断追加的缓存命中前缀。
话不多说,看效果:
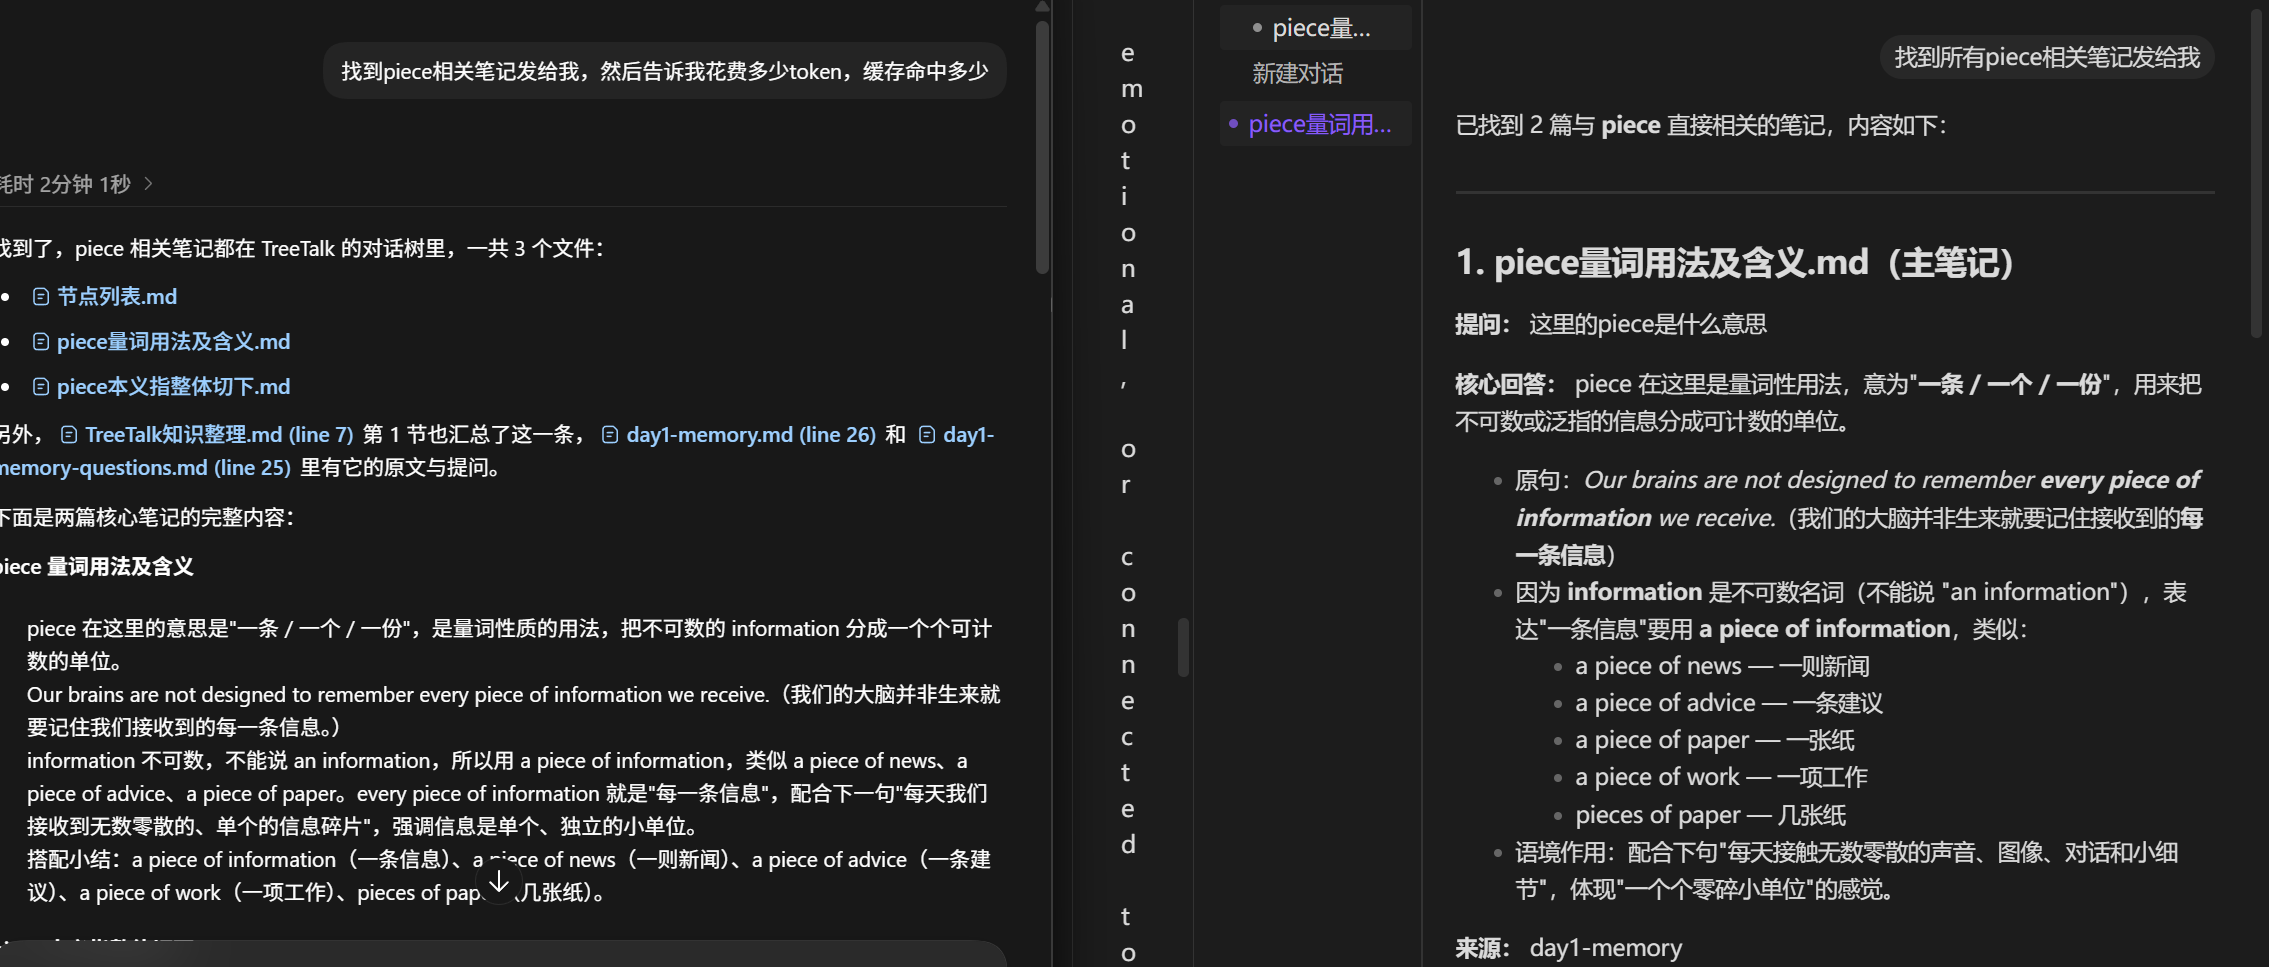
同样的问题和任务《《
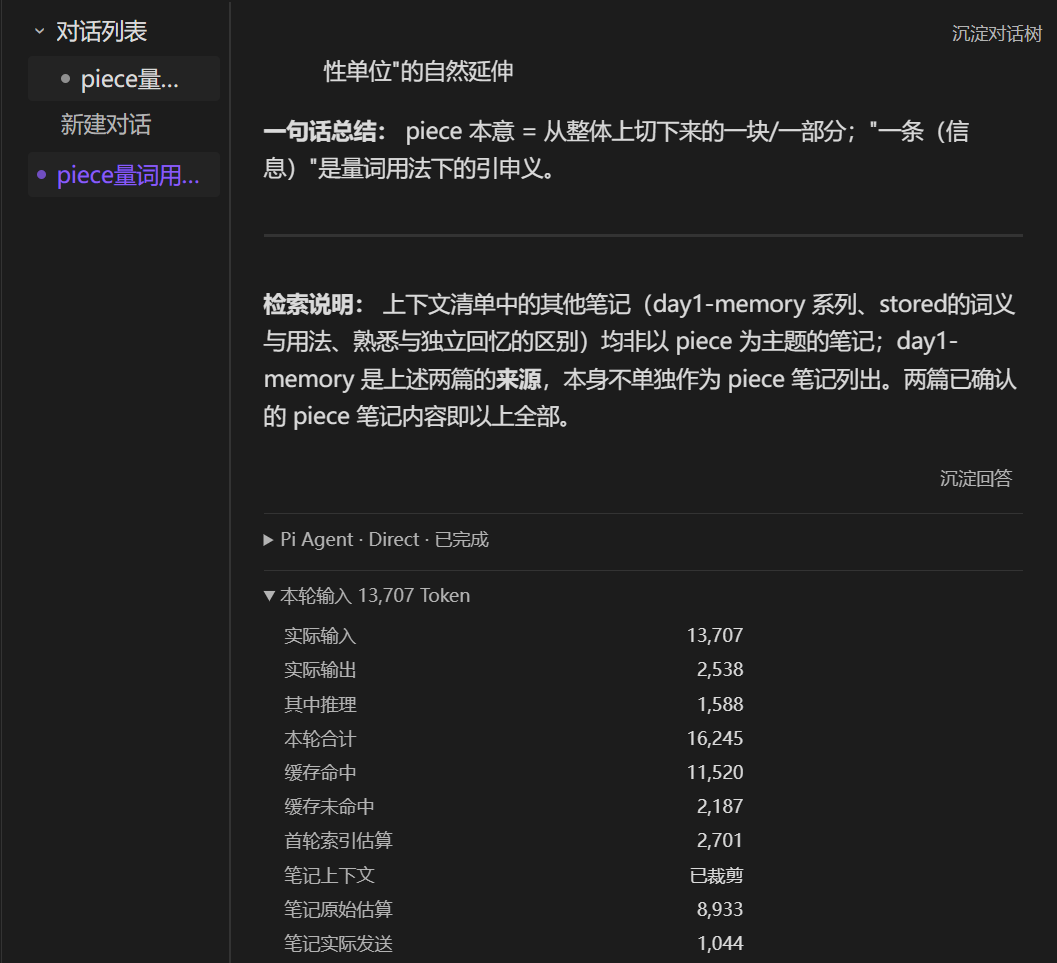
token消耗只有不到10%,实际输出和缓存未命中更低。《《
我知道,只是这样完全不够味
重头戏来了
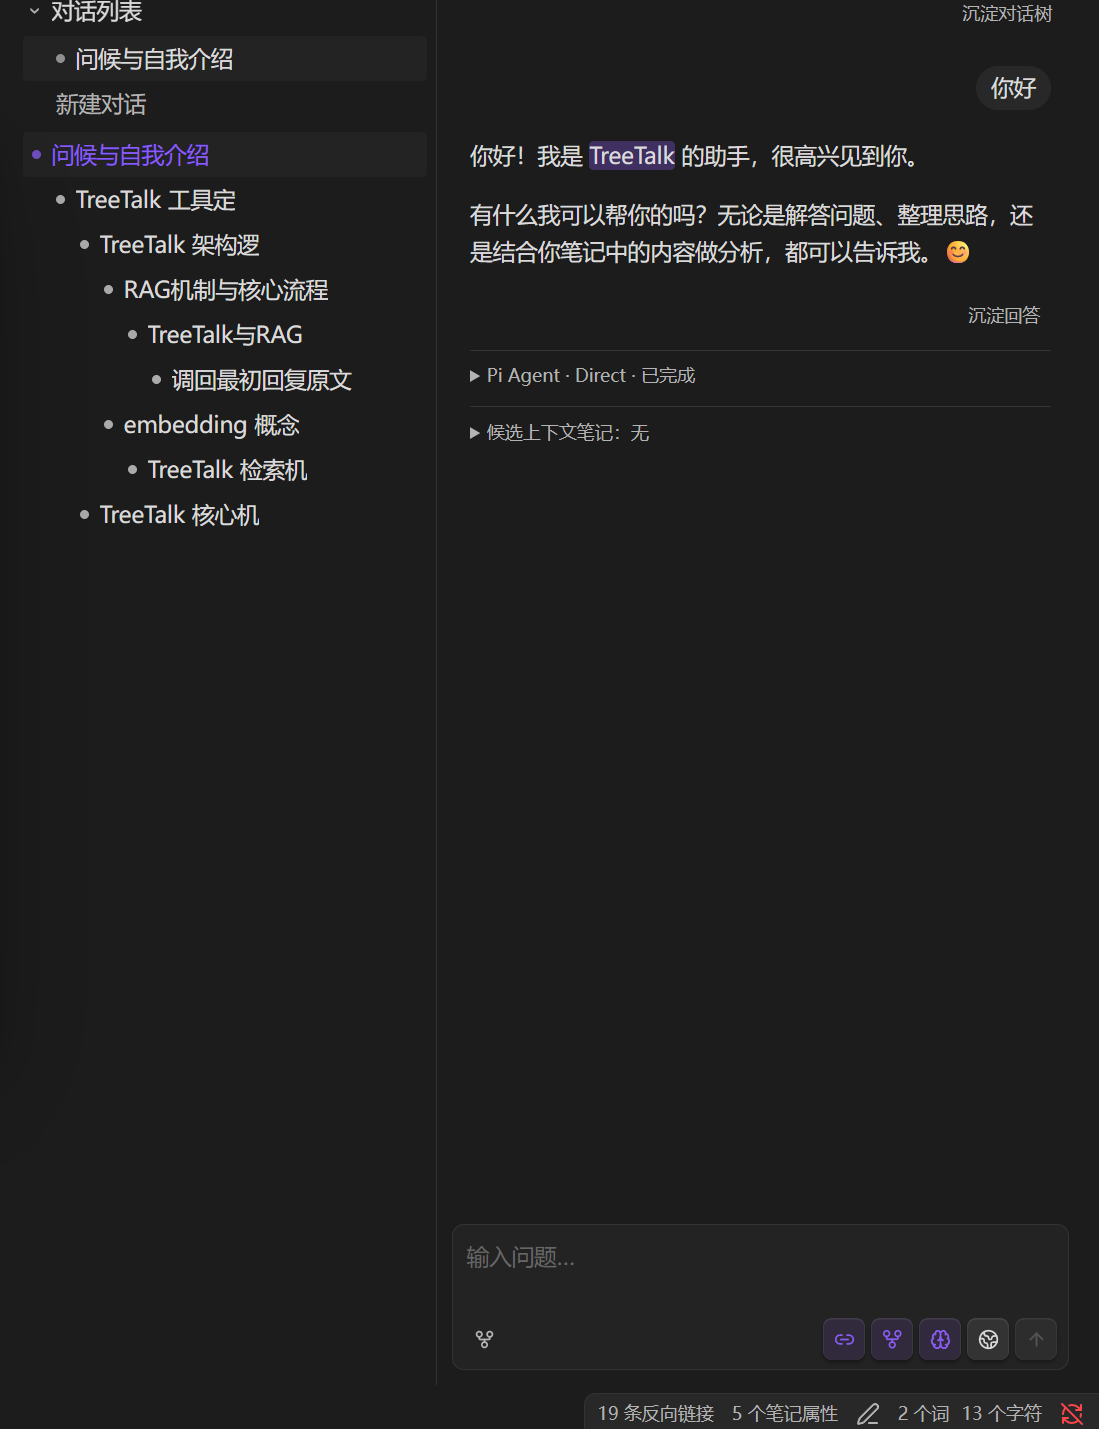
以节点为单位的树状对话。
没错,现在你可以只要点击鼠标的右键,可以随时随地去进行分支了,我承认这真的很有用(当然你也可以直接框选一个概念并提问创建一个新分支,)(同时当你点击沉淀对话树的时候,它会在关联节点的相应位置形成双向链接)
我知道,这个设计实在太老套,不就是一个树吗。
重点是,我让这个树,变得真正有用了。
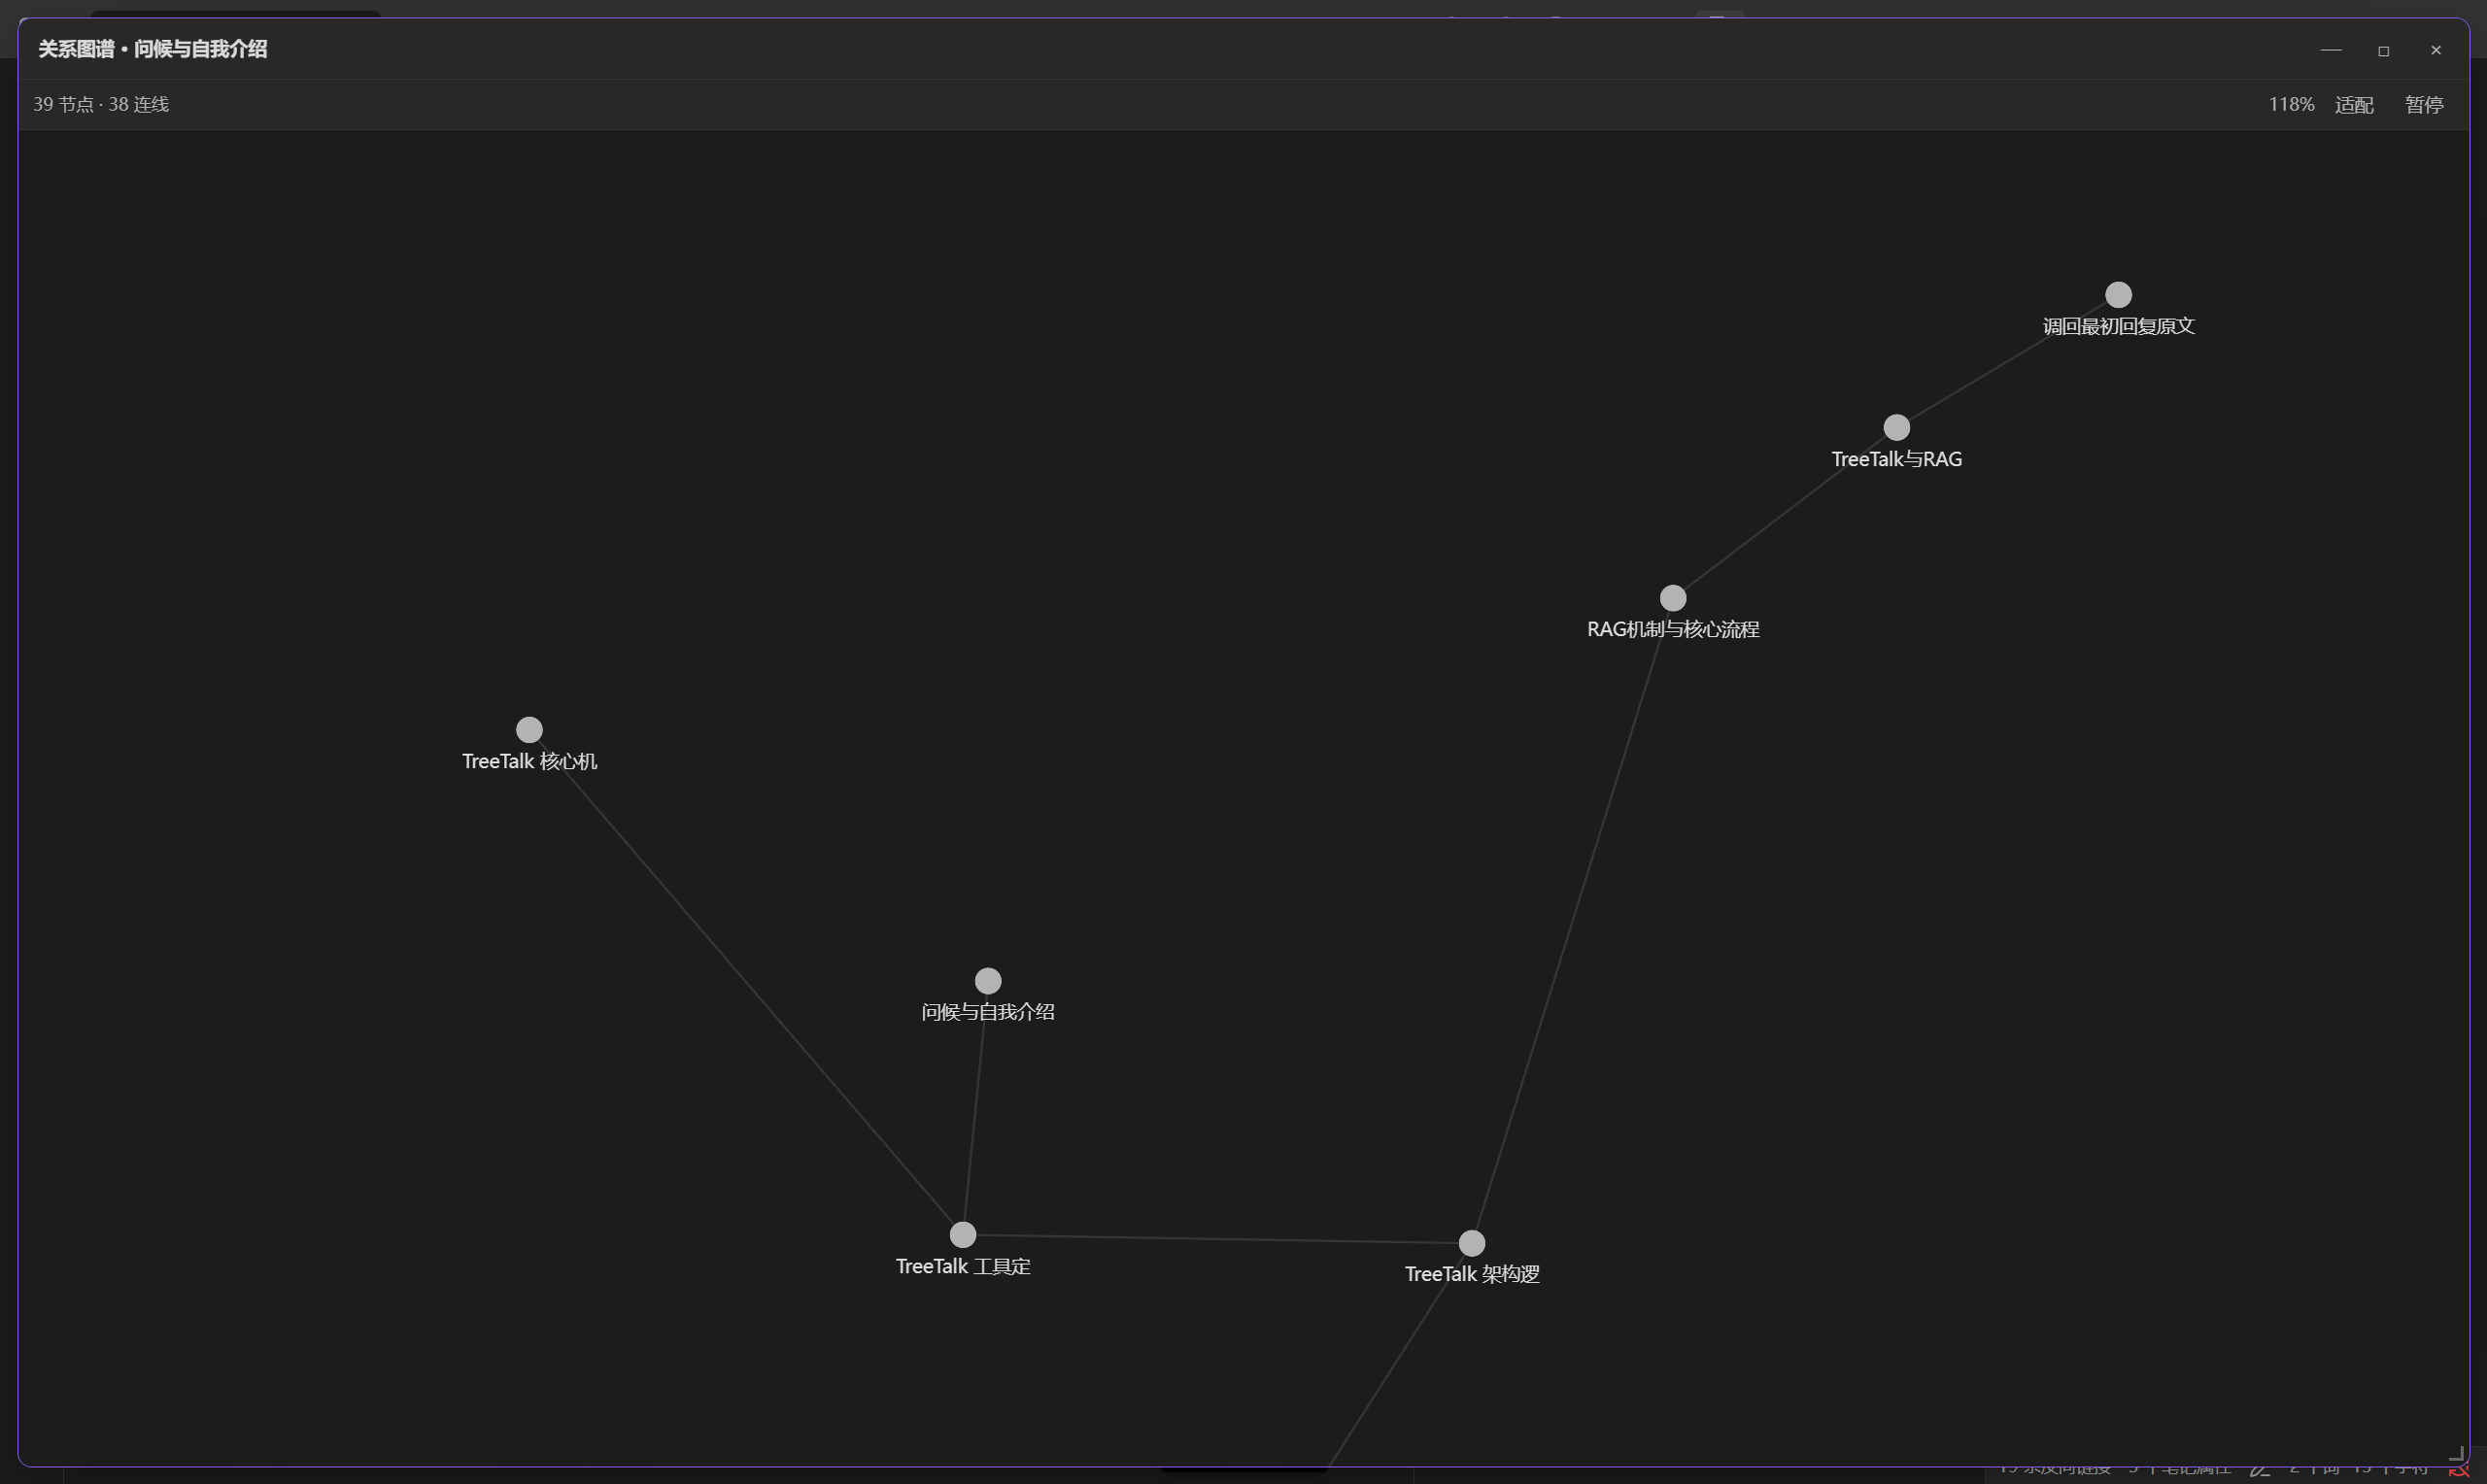
这是插件内的关系图谱,每一个节点,对应你当初的对话空间,全部都好好的保留了。
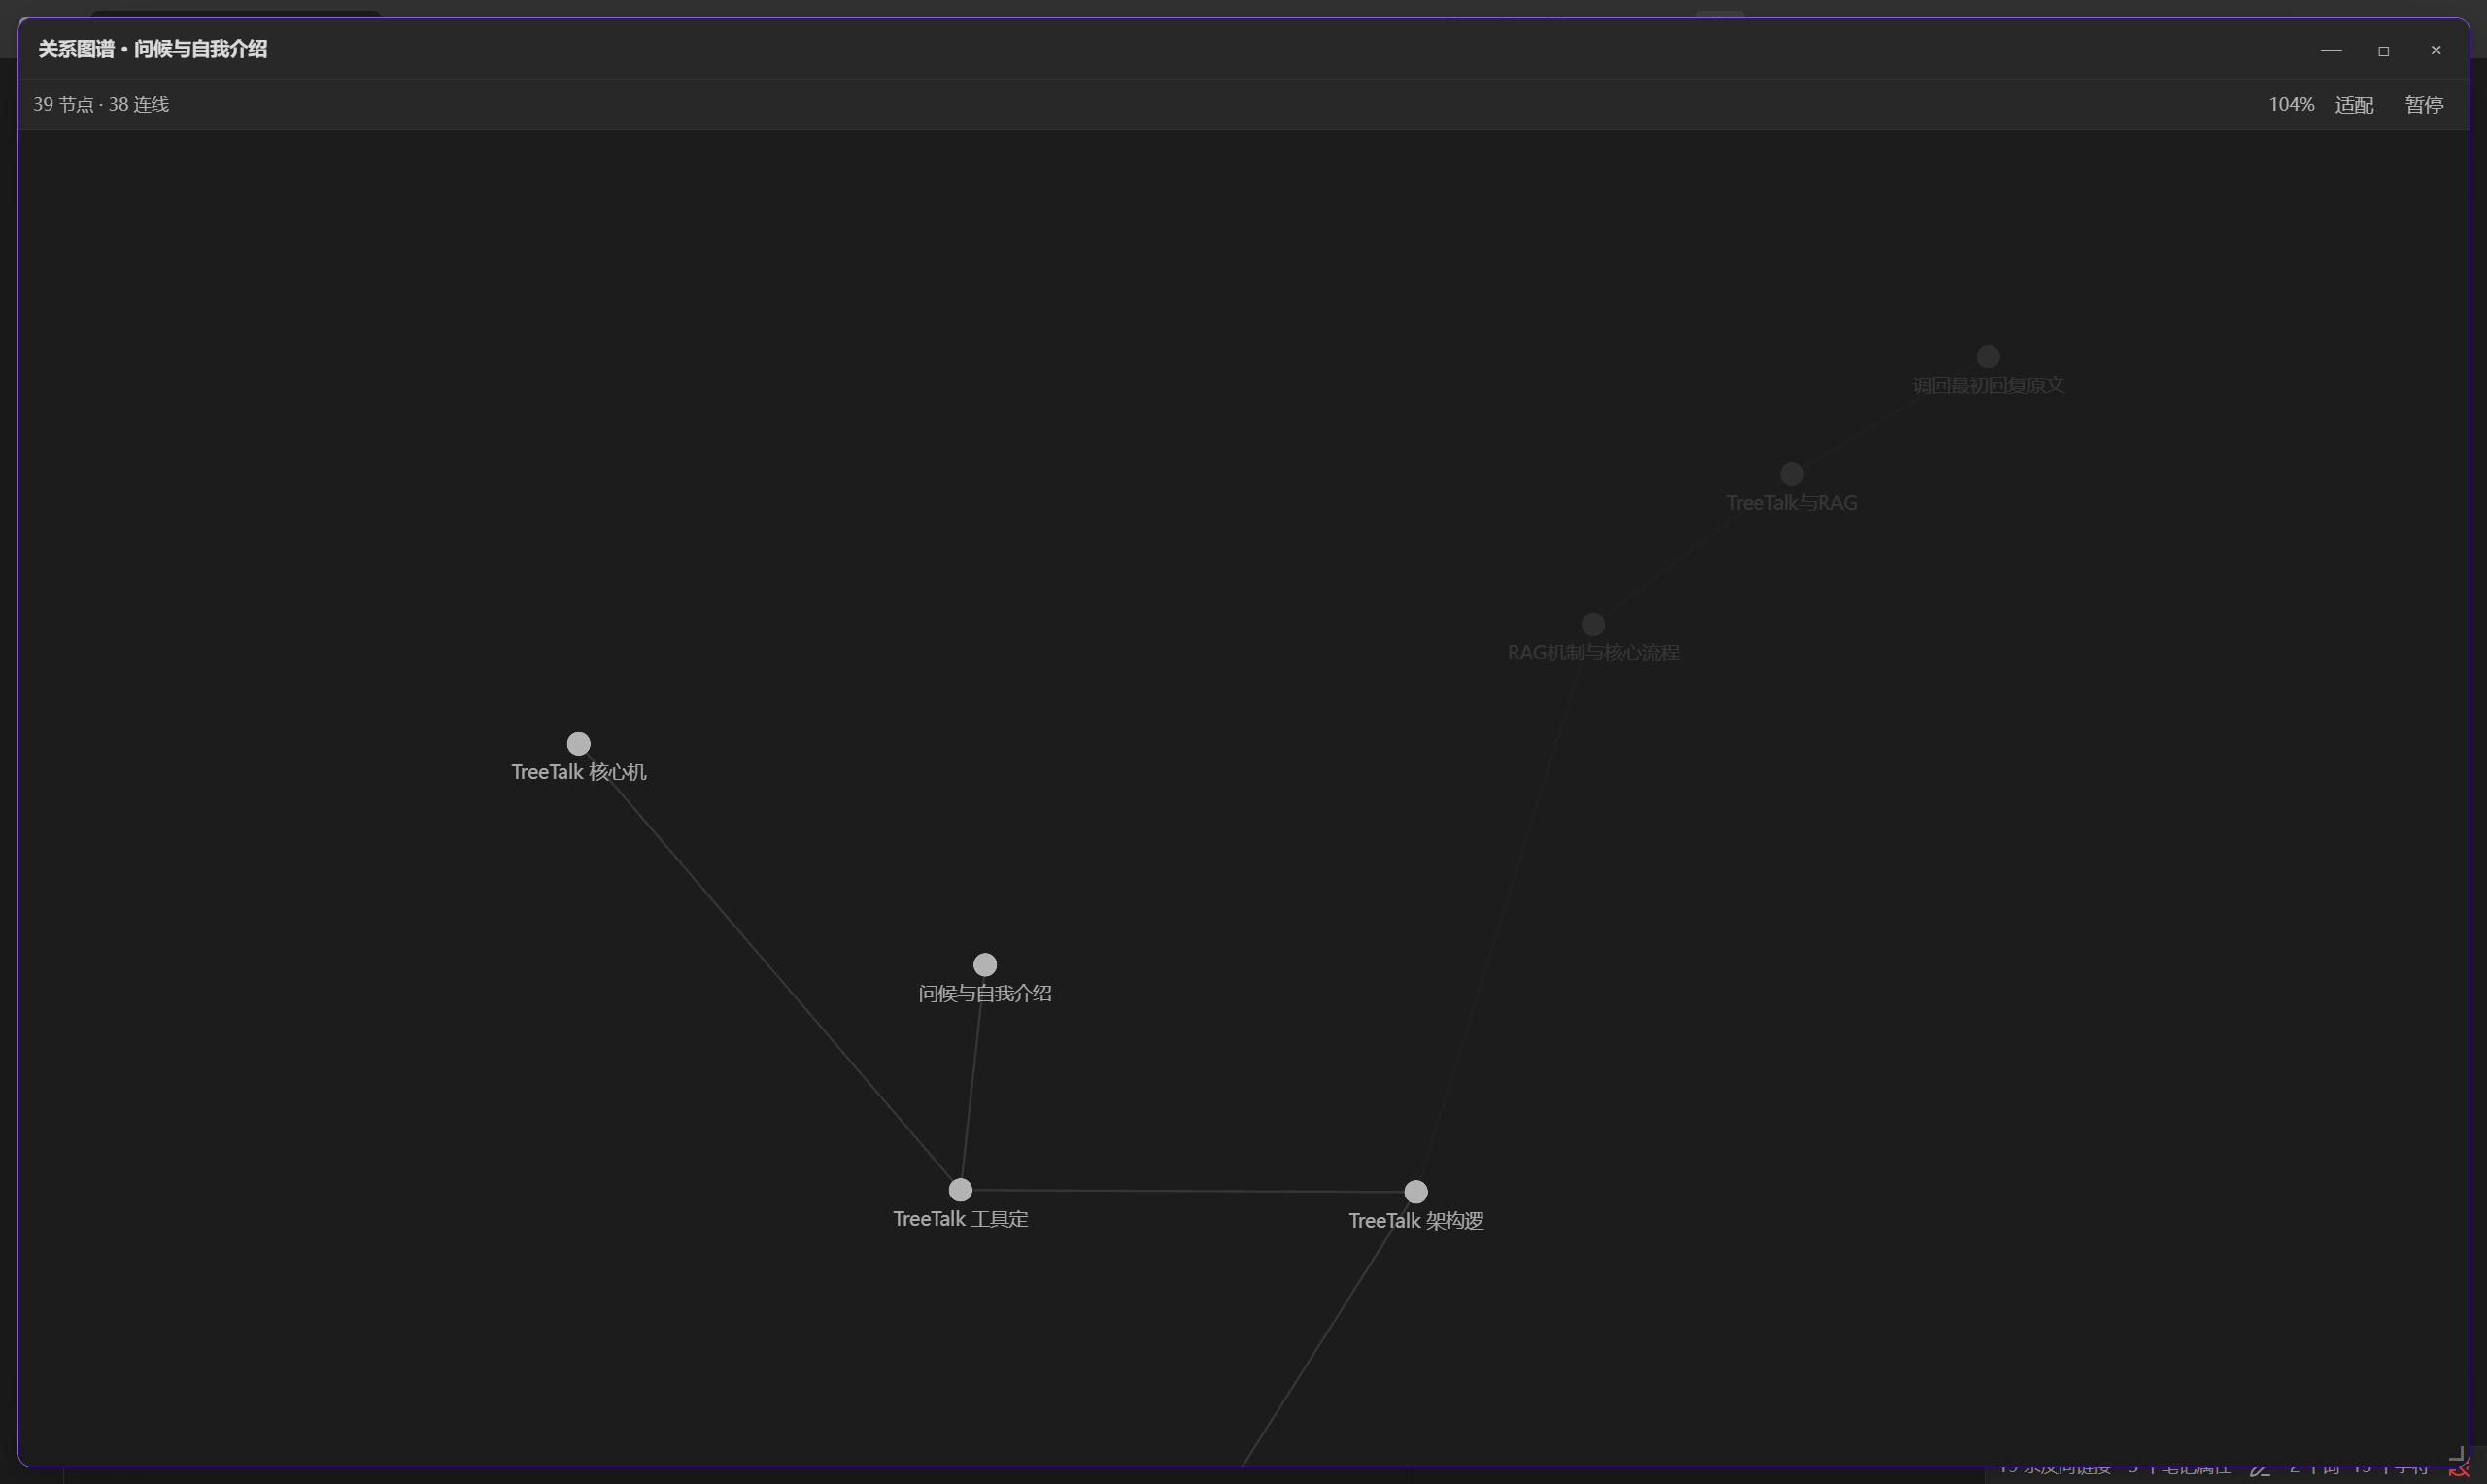
OK,我通过右键点击我不想形成笔记的节点,点击沉淀对话树后,它们不会再出现我的obsidian里。
是的,我让关系图谱变成可操控选择保存笔记的媒介了
最后我来聊聊技术实现吧。
我把上下文分成了四层:L0:精确框选。L1:精确框选附近文本。L2:当前笔记。L3:相关笔记章节。L4:相关笔记全文。
在没开启发散模式(我自己设置的模式)情况下,每一层只会暴露上级接口,模型每一次只在两个选项中做一个事情:1,直接回答。2,调用接口。
是的,这就是最核心的思路了,small to big的渐进式上下文模式(2024年的古老设计)但真的帮到我了。